Разгон и даунвольтинг видеокарт Nvidia в Linux
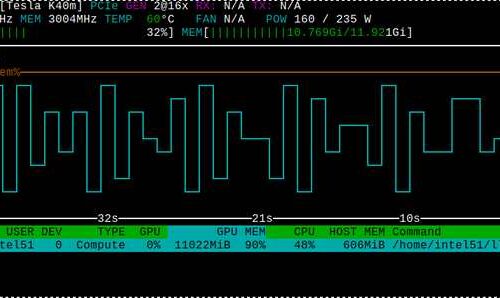
Чтобы управлять на видеокартах Nvidia мощностью, разгоном по памяти и ядру, а также скоростью вращения вентиляторов в linux часто используют утилиты nvidia-settings, nvidia-smi и команды: sudo nvidia-smi -pm 1sudo nvidia-smi -i 0 -pl 100sudo nvidia-settings -a '[gpu:0]/GPUFanControlState=1'sudo nvidia-settings -a '[fan:0]/GPUTargetFanSpeed=35'sudo nvidia-settings -a '[gpu:0]/GPUMemoryTransferRateOffset[3]=450'sudo nvidia-settings -a '[gpu:0]/GPUGraphicsClockOffset[3]=130'sudo nvidia-settings -a '[gpu:0]/GPUPowerMizerMode=1' В этом случае скорость вращения вентиляторов устанавливается на заданное значение, которое не всегда является оптимальным. В простое видеокарты создают лишний шум, происходит выработка ресурса подшипников, а в режиме максимальной нагрузки на GPU, наоборот, такого потока воздуха может не хватать. Для решения проблемы можно использовать скрипт, задействующий библиотеку nvml. При этом можно будет добиться не только управления частотами и скоростью вращения fan,…
llama.cpp на двух компьютерах через прямое соединение
Для увеличения доступного объема VRAM при локальных AI-вычислениях можно использовать распределённый инференс больших моделей между двумя машинами, соединёнными патч-кордом напрямую (без свитча), через встроенный RPC-backend llama.cpp. Он специально создан для распараллеливания инференса одной нейросети на нескольких компьютерах (технология pooling VRAM — запуск моделей, которые не влезают в память одной видеокарты). В режиме rpc одна машина выступает координатором (запускает llama-cli или llama-server), другая — вычислительным узлом (rpc-server), который просто исполняет операции над тензорами по сети. При этом слои модели распределяются между локальными GPU и удалёнными узлами. Важно понимать ограничения такой «солянки»: Это не настоящий tensor-parallelism с overlap вычислений и передачи данных, здесь каждый слой считается последовательно, и пока узел B не…
ComfyUI генерирует чёрный квадрат/артефакты вместо изображения. Что делать?
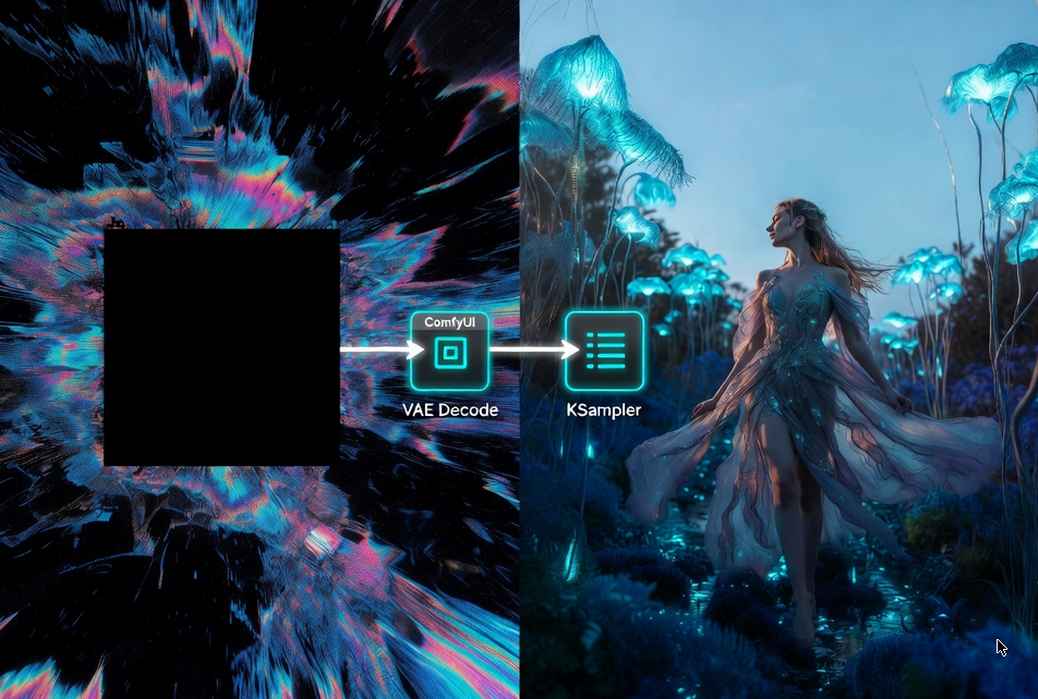
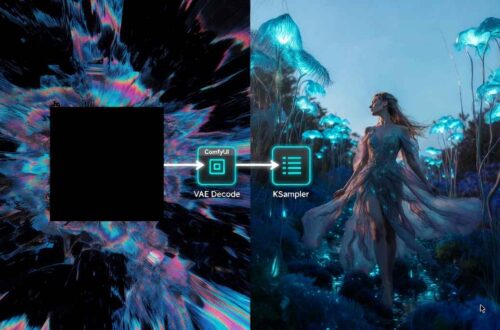
Иногда после успешного прохождения цикла генерации в ComfyUI вместо ожидаемого изображения появляется чёрный квадрат, серый шум, сильные цветовые артефакты или полностью испорченная картинка. Пример сбоя (промпт: «A fashion photography work full of surreal romanticism, using a low-angle upward shooting composition, with a clear light blue sky as the background, and the visual focus concentrated on the fantasy blue vegetation and the model walking through it»): Генерация «Черного Квадрата» Малевича вместо желаемого промта: Подобные ошибки могут возникать из-за следующих причин: Чтобы исправить генерацию цветового шума/черных квадратов вместо желаемого изображения можно использовать следующие способы: Рекомендуется использовать надёжный VAE, например: Кроме того, можно попробовать добавить Load VAE → VAEDecode из стандартных официальных нод,…
«Никелирование» llama.cpp на компьютере с несколькими GPU Nvidia
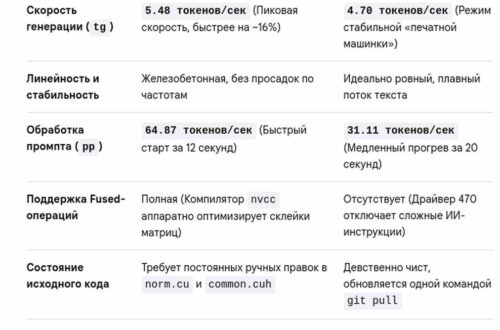
Программное окружение llama.cpp является одним из лучших инструментов для работы с локальными AI-моделями. Сообщество активно развивает проект: регулярно появляются новые оптимизации, поддержка аппаратных ускорений и рост скорости инференса. Одной из «фишек» llama.cpp является поддержка практически любых видеокарт, а также возможность распределения больших AI-моделей на нескольких видекоартах. В этом случае большое влияние на скорость проведения вычислений оказывает полоса пропускания общей шины памяти, то, насколько быстро производится обмен данными между GPU, CPU и RAM компьютера. Упрощенная формула для расчета скорости инференса в зависимости от пропускной способности памяти: Реальная скорость проведения вычислений ниже теоретической, зависит от bandwidth памяти и скорости interconnect между картами. Из-за различных задержек система выдает около 60–90% от максимума. Для…
Отключение USB‑контроллеров и аудио-устройств видеокарт для освобождения ресурсов шины PCI-E в Linux
Для ускорения инференса в multiGPU-системе критически важно обеспечить максимальную пропускную способность обмена между видеокартами по шине PCI-E. Для этого можно отключить все неиспользуемые устройства, подключенные к ней, например, аудио, а также обычно неиспользуемые VirtualLink USB-контроллеры видеокарт (работают через DisplayPort на VR-устройствах). Снижение нагрузки на шину PCI-E, уменьшение потребления ресурсов, отключение ненужных драйверов улучшит стабильность и производительность системы, что особенно важно в мульти-GPU конфигурациях. Изучить информацию о подключении видеокарт Nvidia к шине PCI-E можно по команде: lspci | grep -E "USB|Audio" | grep -i nvidia 01:00.1 Audio device: NVIDIA Corporation TU116 High Definition Audio Controller (rev a1)01:00.2 USB controller: NVIDIA Corporation TU116 USB 3.1 Host Controller (rev a1)01:00.3 Serial bus controller:…
Обзор криптовалюты Pearl coin (PRL), майнинг на алгоритме Pearlhash
Pearl (PRL) — это относительно новая Proof-of-Useful-Work (PoUW) криптовалюта, которая запустила mainnet 27 апреля 2026 года. Проект Pearl позиционирует себя как мост между майнингом и искусственным интеллектом. Вместо традиционного хэширования майнерами выполняются операции умножения матриц (matrix multiplication) на видеокартах (пока только NVIDIA) — те же вычисления, которые используются в обучении и инференсе больших языковых моделей искусственного интеллекта. Теоретически, это позволяет говорить о «полезных» PoW-вычислениях: энергия оборудования тратится не только на создание новых блоков и обеспечение безопасности сети, но и потенциально приносит пользу AI-индустрии. Что такое Pearl Network? Pearl является детищем Pearl Research Ltd (ивр. פרל ריסרצ’ בע»מ), израильской компании, зарегистрированной 11 февраля 2025 года по адресу 35 HaMisger St., Tel…
Устранение ошибки RuntimeError: comfy-aimdo device is not initialize в comfyui
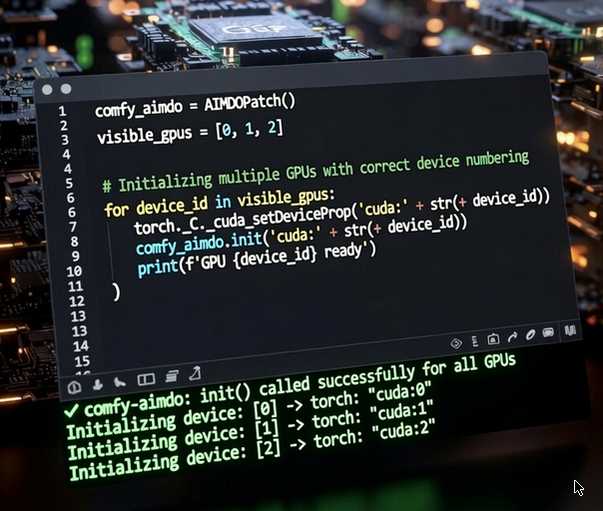
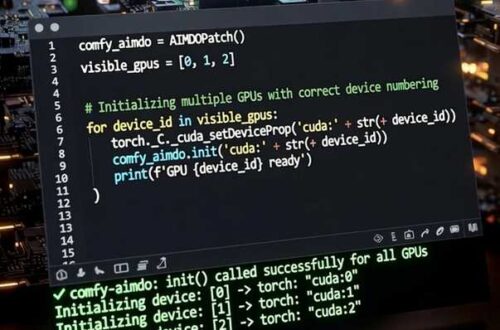
Для решения проблем с нехваткой памяти при работе с нейросетями и платформой PyTorch часто используется модуль AIMDO (AI Model Dynamic Offloader), который автоматически выгружает часть модели искусственного интеллекта в системную память при переполнении VRAM. Благодаря этому даже на компьютерах с относительно слабыми видеокартами с малым объемом памяти можно запускать крупные модели AI. В окружении comfyui распределитель памяти AIMDO можно командой: python -m pip install --upgrade comfy-aimdo К сожалению, при запуске AI-моделей в comfyui с одновременным использованием AIMDO и ноды MultiGPU (например, для загрузки CLIPTextEncoder в память другой видеокарты) может появляться ошибка RuntimeError: comfy-aimdo device is not initialize: Она появляется из-за того, что модуль динамической памяти AIMDO при загрузке окружения comfyui…
Запуск AI-моделей в llama.cpp на AMD Radeon RX470 8GB с Vulkan в gentoo
Использование искусственного интеллекта в настоящее время стало обыденностью. По ряду причин, имеет смысл ограничивать объем персональных данных, отдаваемых «Большому Брату» в ходе его использования. При наличии мало-мальски производительного компьютера (16GB+ RAM и 8GB+ VRAM) на нем можно запускать локальные AI-приложения, избавившись от необходимости платить за подобные сетевые услуги, а также сократив объем своего «личного дела» у третьих лиц. Для запуска локального AI удобно использовать программное окружение llama.cpp. Среди его преимуществ можно выделить следующие: В наличии множества пользователей до сих пор имеется множество видеокарт AMD поколения Polaris с 8GB памяти (AMD Radeon RX серий 470-590). Несмотря на частичное прекращение поддержки таких графических ускорителей (например, на них невозможно использовать последние версии rocm),…
Активация FlashAttention в comfyui для Nvidia Tesla V100 в linux
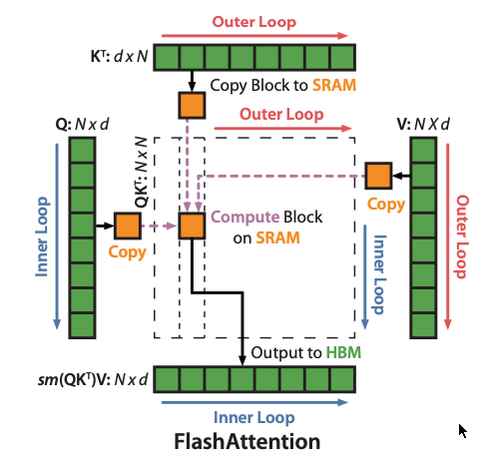
AI-вычисления требуют наличия большого объема быстродействующей памяти, а также использования новейшего программных модулей, в полной мере раскрывающих возможности имеющегося оборудования. Для видеокарты Nvidia Tesla V100 в comfui для этого можно установить модули Triton 3.2.0 и SageAttention 1.0.6: pip install sageattention==1.0.6 triton=3.2.0 Для еще большего увеличения быстродействия вычислений на видеокарте Nvidia Tesla V100 (и на других подходящих ускорителях) в comfyui желательно использовать программный модуль FlashAttention. В нем задействован алгоритм эффективного вычисления внимания (attention) в AI-трансформерах, который значительно ускоряет инференс и уменьшает загрузку памяти на GPU. Технология FlashAttention (Fast and Memory-Efficient Exact Attention with IO-Awareness) использует оптимизированный алгоритм работы с памятью GPU, включающий следующие элементы: Благодаря FlashAttention, сохраняя тот же математический результат,…
Кевин Уорш возглавил ФРС США: что это значит для биткоина?
Назначение Кевина Максвелла Уорша на пост председателя Федерального резерва США вызвало широкий резонанс среди инвесторов. Многие пытаются понять, как новая денежно-кредитная политика повлияет на стоимость криптовалют и цифровых активов. 15 мая 2026 года главой Федеральной Резервной системы США стал Кевин Максвелл Уорш (Kevin Maxwell Warsh). Его кандидатуру на эту должность выдвинул президент США Д.Трамп. Назначение было одобрено Сенатом США 13 мая 2026 года 54 голосами за и 45 — против. К.Уорш является выпускником Гарварда и Стэнфорда, бывшим топ-менеджером Morgan Stanley и одним из самых молодых руководителей в истории ФРС (он занимал пост управляющего с 2006 по 2011 годы). В разгар финансового кризиса 2008 года Уорш был одним из ключевых связующих…