Вынос clip, vae и lora на другой компьютер в comfyui
Современная генеративно-диффузионная индустрия развивается стремительно, но у этого прогресса есть обратная сторона — колоссальный рост системных требований. Такие DiT-модели, как Flux, Krea-2, SD3 и другие, требуют десятки гигабайт VRAM для загрузки весов, контекста и работы апскейлера, что часто приводит к необходимости жертвовать качеством ради возможности вообще запустить рабочий процесс.
Пытаясь запустить воркфлоу с современной AI-моделью на среднем или слабом домашнем компьютере, пользователь неизбежно сталкивается с торможением, вызванным постоянной загрузкой-выгрузкой больших файлов в память видеокарты/ОЗУ, необходимостью очищать кэш и вылетами по ошибке OOM (Out Of Memory).
На первый взгляд, самым простым решением этой проблемы является покупка новой мощной и дорогой видеокарты. Однако, это не всегда приемлемо по разным причинам. Проблему можно решить, если в наличии имеется еще один или несколько компьютеров, распределив нагрузку между ними. Это возможно благодаря кастомному расширению comfy_remote_run от LatentRat, которое позволяет разрезать процесс генерации в comfyui на независимые блоки и отдать их выполнение на компьютеры, подключенные по локальной сети.
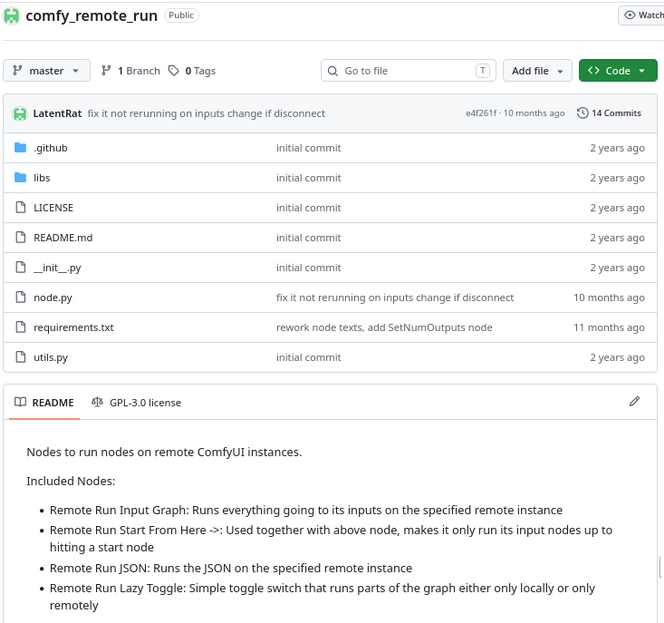
При использовании comfy_remote_run на другую машину можно переносить не только текстовый энкодер (CLIP), но и другие модули. Далее рассматривается работа с классическим пайплайном генерации с моделью Krea-2 с выносом его отдельных элементов: CLIP, KSampler и VAE.
Что дает перенос CLIP, LORA и VAE на другой компьютер?
Текстовый энкодер (CLIP/LLM) является мощным пожирателем памяти компьютера. Он переводит текстовый промпт, понятный человеку, в адаптированные для нейросети математические векторы (кондишены). Современные модели для этого используют полноценные тяжелые языковые модели (LLM). Качественные несжатые модели весят очень много — от единиц до десятков гигабайт. Например, CLIP qwen3-vl-4b_f16.safetensors для Krea-2 занимает в памяти около 8.4 Гб. Если загрузить его локально на слабом ПК, он забивает всю VRAM еще до того, как начнется генерация. Благодаря выносу CLIP на ведомую машину, компьютер-мастер полностью освобождает свою память от удержания огромных текстовых весов. При работе мастер отправляет по сети несколько килобайт текста промпта, а обратно получает готовый, компактный математический вектор кондиционирования. Для работы такой связки не требуется соединения с высокой пропускной способностью.
Семплирование (KSampler / Диффузия) — главный вычислительный движок, который берет случайный цифровой шум и, опираясь на подсказки от CLIP, превращает его в очертания будущего изображения внутри «латентного пространства» (скрытого математического пространства). Это математически затратный этап, требующий максимальной вычислительной мощности GPU и большого количества памяти. Например, диффузионная модель Krea-2, даже сжатая по стандартам FP8 или INT8 сама по себе занимает от 12 Гб VRAM и выше. Поскольку это ядро генерации, его логично оставить на машине-мастере, чтобы иметь полный локальный контроль над сидами, шагами и планировщиками.
Декодирование (VAE Decode) берет сгенерированную в KSampler латентную матрицу (несколько сотен килобайт) и «разворачивает» её в пиксельное изображение высокого разрешения. В момент финального просчета VAE Decode требует резкого, взрывного выделения видеопамяти. При генерации картинок в Krea-2 потребление видеопамяти на несколько секунд вырастает на несколько гигабайт. Поэтому на этапе VAE Decode, в конце генерации, часто происходят вылеты по ошибке Out Of Memory. Вынос этого этапа на другой компьютер вполне оправдан, так как передача латентного кадра из KSampler на ведомый ПК по сети занимает доли секунды (пакет весит менее 1 Мб).
Таким образом, разделяя воркфлоу, ведомый компьютер можно превратить в своеобразный «сопроцессор». В ходе работы мастер-компьютер освобождается от необходимости непрерывно выгружать тяжелый CLIP, освобождая место для KSampler, а затем выгружать последний ради VAE. Ведомый компьютер берет на себя работу с текстом и финализацию пикселей, а мастер занимается циклами генерации в Ksampler.
В этой статье рассматривается распределение задач рабочего процесса comfyui на два компьютера:
- основной компьютер с Nvidia Tesla V100 16GB — главный воркфлоу, работа с UNET и, при необходимости, upscaler;
- второй компьютер в локальной сети — работа с CLIP (текстовый энкодер), VAE и вынос LORA.
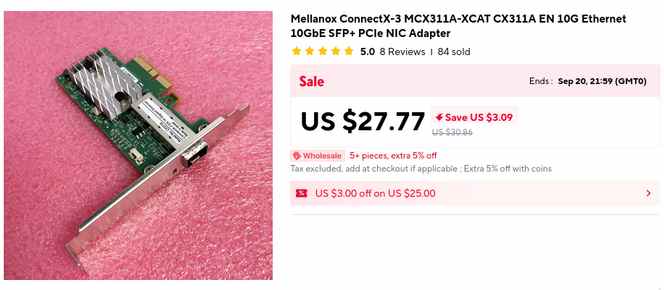
Сетевые задержки в этой конфигурации сведены до минимума благодаря использованию высокоскоростного обмена по 10G сети. Хотя для генерации картинок в comfyui высокая пропускная способность сети не требуется, все же стоит увеличить ее хотя бы до 2.5, а лучше 10Gbit. Это пригодится для распределенного запуска больших LLM-моделей. Небольшой высокоскоростной сегмент локальной сети можно создать, используя неуправляемый 10G-коммутатор с Aliexpress и б.у. серверные сетевые карты Mellanox (или им подобные), например:
Перенос LORA, модулей CLIP и VAE на компьютер с двумя старыми видеокартами (1000-1600-й серии), подключенными по линку PCI-E x8 не только не снизил скорость инференса, но и ощутимо добавил ему прыти (от нескольких до десятков секунд в зависимости от разрешения и количества батчей).
При тестировании также выяснилось, что для видеокарт Nvidia Tesla V100 использование популярных int8-моделей (сжатая версия занимает около 12-13 ГБ) является не самым лучшим выбором из-за малой скорости деквантования этого формата. Благодаря наличию тензоров, заточенных под вычисления в FP16, в два раза большая AI-модель размером почти 24ГБ на Nvidia Tesla V100 с 16GB VRAM работает быстрее (примерно на 25-30%) модели, полностью вмещающейся в ее память, но в формате FP8 или int8convrot, несмотря на оффлаудинг в ОЗУ. При этом качество генерируемой картинки выше, чем при генерации с fp8/int8-ConvRot-кодированием.
Вынос CLIP, LORA и VAE в comfyui на другой компьютер с помощью расширения comfy_remote_run
Сначала на удаленный компьютер устанавливаем ComfyUI:
git clone https://github.com/comfy-org/ComfyUI.git && cd ComfyUI
python -m venv venv
source ./venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
Для видеокарт старее Turing (например, Pascal), используем pytorch 2.14 с CUDA 12.6:
source ./venv/bin/activate
pip3 install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu126
Для удобства работы с расширенями инсталлруем ComfyUI-Manager:
pip install -r $HOME/ComfyUI/manager_requirements.txt
Для старых процессоров, которые аппаратно не могут работать с инструкциями AVX2, например, Intel Core i5-3570K на архитектуре IvyBridge, собираем kornia_rs с поддержкой нативных инструкций (флаг no-binary):
cd $HOME/ComfyUI/ && source ./venv/bin/activate
sudo -u intel41 bash -c "source $HOME/ComfyUI/venv/bin/activate && pip install --force-reinstall --no-binary kornia_rs kornia_rs"
Так как воркфлоу будет управляться с другого компьютера,подключенного по сети, придется снизить уровень безопасности в конфигурационном файле ComfyUI-Manager (в linux это обычно файл $HOME/ComfyUI/user/__manager/config.ini).
Туда нужно вписать строки:
allow_git_url_install = true
allow_pip_install = true
security_level = weak
Параметр security_level = weak вместе с allow_git_url_install/allow_pip_install разрешает управлять установкой расширений с любой машины, имеющей доступ к этому ComfyUI.
Нужно отдавать себе отчет, что в связке с —listen 0.0.0.0 и —enable-cors-header ‘*’ это стоит делать только в доверенной локальной сети за NAT/файрволом.
Желаемые расширения можно устанавливать и без модификации установок безопасности ComfyUI-Manager, вручную клонируя нужный репозиторий в папку с кастомными нодами (/ComfyUI/custom_nodes/) командами в терминале. Например, для установки comfy_remote_run выполняем команды:
cd $HOME/ComfyUI/ && source ./venv/bin/activate
cd $HOME/ComfyUI/custom_nodes/ && git clone https://github.com/LatentRat/comfy_remote_run && cd comfy_remote_run/ && pip install -r requirements.txt
Чтобы компьютер-нода мог выполнять команды с основного воркфлоу, у них должны быть синхронизированы версии ComfyUI, расширений и содержимое папок, использующихся в работе (нужно установить на него те же самые расширения, что и на компьютере-мастере, а также скопировать туда необходимые нейросетевые модели под теми же названиями).
cd $HOME/ComfyUI/ && source ./venv/bin/activate
cd $HOME/ComfyUI/custom_nodes/ && git clone https://github.com/pollockjj/ComfyUI-MultiGPU
и т.д.
После этого можно запускать удаленный экземпляр ComfyUI с включенным разрешением CORS-запросов и разрешенным доступом по сети, например, скриптом start_comfy.sh:
#!/bin/bash

nvidia-smi -pm 1

nvidia-smi -i 0 -pl 100

nvidia-smi -i 1 -pl 100

export CUDA_MODULE_LOADING=LAZY

export CUDA_VISIBLE_DEVICES=0,1

export PYTORCH_CUDA_ALLOC_CONF='garbage_collection_threshold:0.6,max_split_size_mb:64,expandable_segments:True'

source ./venv/bin/activate

python3 main.py --listen 0.0.0.0 --port 8188 \

--highvram \

--fast \

--disable-metadata \

--enable-cors-header '*' \

--enable-manager
workflow в ComfyUI машины, подключенной по сети, запускать не нужно.
Дальнейшая работа производится с компьютера-мастера, подключаясь к ведомой машине через браузер по адресу в формате: адрес_локальной_сети:порт, например, 192.168.2.41:8189.
После установки comfy_remote_run, создаем (или загружаем готовый подходящий) воркфлоу в comfyui компьютера-мастера. Затем добавляем на холст нужные узлы, используя меню, выпадающее при нажатии на холст правой кнопкой мыши:
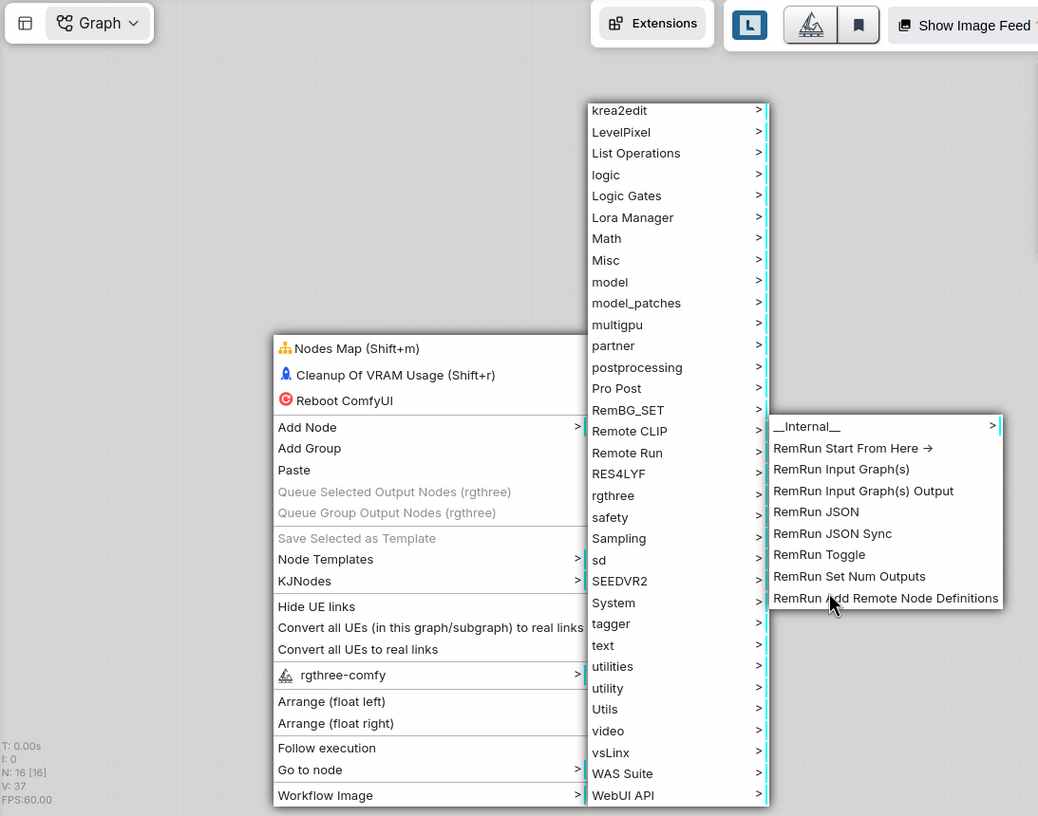
В данном случае, дополнительно к обычным, устанавливаем следующие узлы comfy_remote_run:
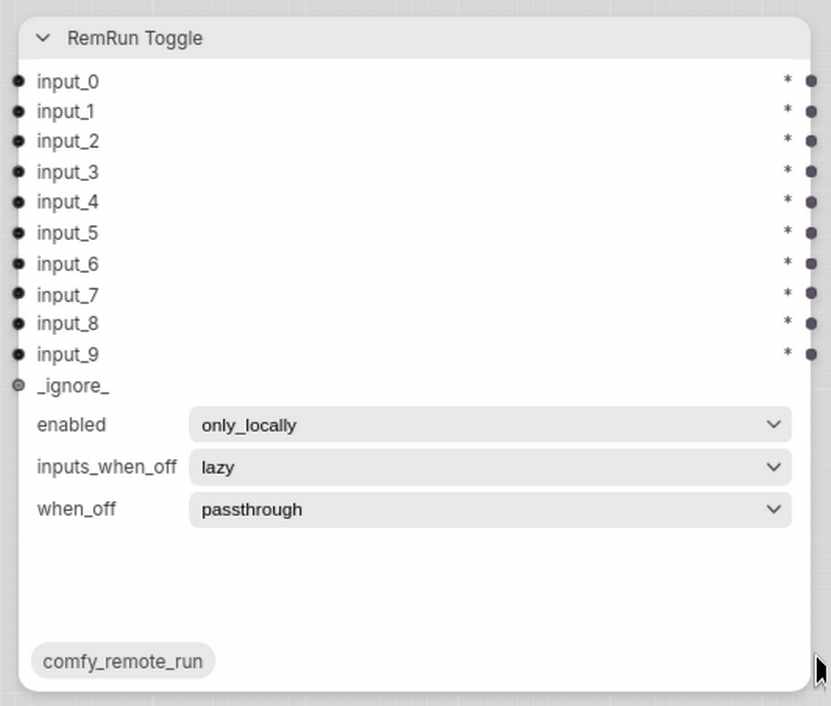
- переключатель RemRun Toggle — две штуки. Эти узлы нужны для переключения режима работы подключенного к узлу графа (локальный или удаленный);
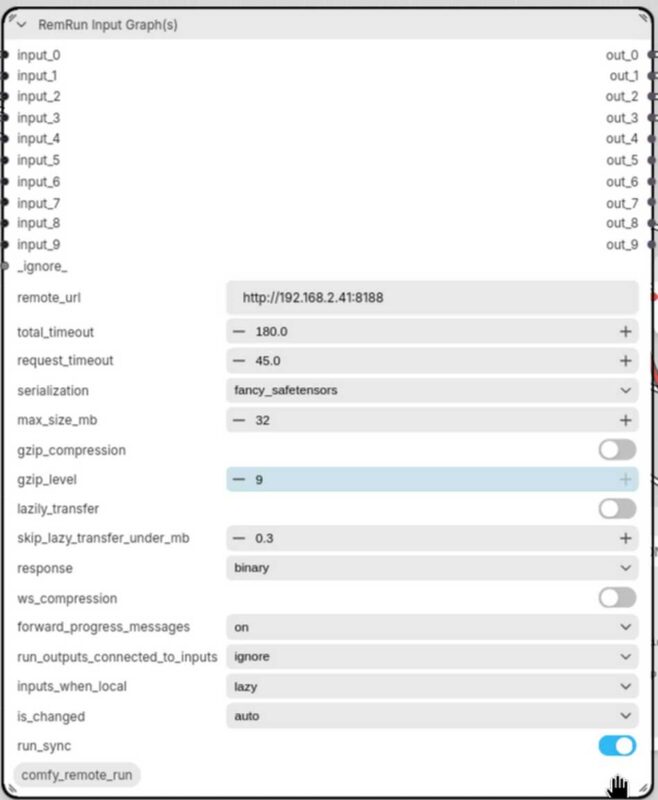
- RemRun Input Graph(s) — две штуки. Эти графы нужны для запуска подключенных ко входам данного узла модулей на удаленном компьютере (в рассматриваемом случае — CLIP, VAE и LORA);
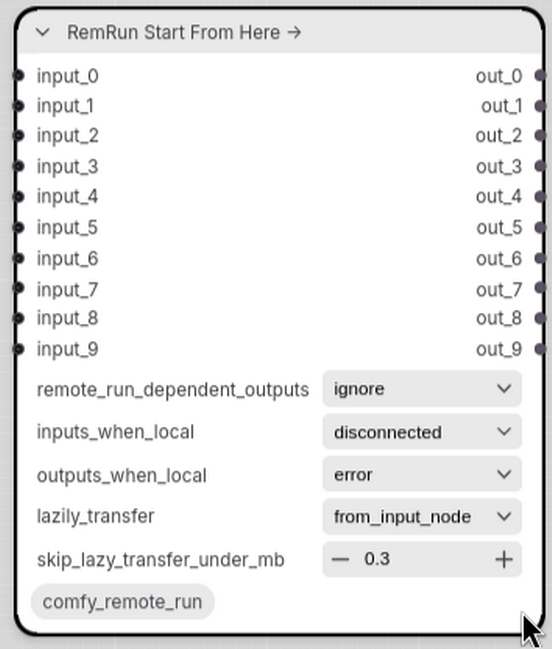
- RemRun Start From Here — один, используется вместе с RemRun Input Graph для передачи сгенерированных данных (или промежуточных тензоров) обратно на мастер-машину либо для указания точной точки в графе, с которой должно начаться удаленное выполнение вычислений. Этот узел связывает локальную и удаленную части воркфлоу, чтобы мастер-компьютер понимал, где заканчивается его собственная работа и где управление перехватывает ведомая (remote) машина.
Для работы с CLIP, LORA и VAE используются стандартные ноды, которые изолируются и переносятся на другой компьютер с помощью comfy_remote_run. Для multigpu-конфигурации в воркфлоу удобно подключать узлы multigpu, например, CLIPLoaderDisTorch2MultiGPU:
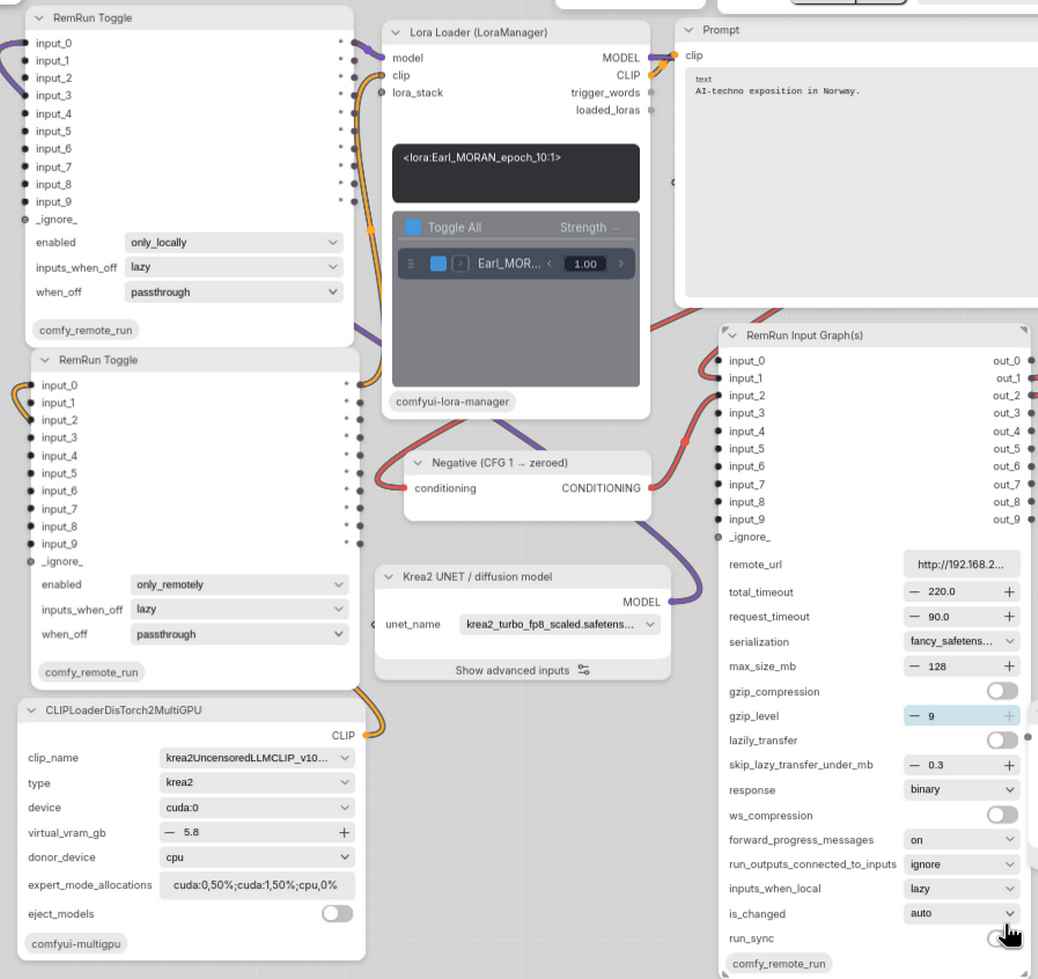
В воркфлоу нужно внести следующие изменения для выноса CLIP, LORA и VAE:
Выход MODEL от UNETLoader пропускается через первый узел RemRun Toggle, в поле enabled которого выставляется режим only_locally. При этом диффузионная модель остается работать локально на мастере.
Выход CLIP от CLIPLoaderDisTorch2MultiGPU пропускается через второй узел RemRun Toggle. В его поле enabled выставляется режим only_remotely. Благодаря этому текстовый энкодер обрабатывается на удаленной машине, не занимая локальную память.
Выходы MODEL и CLIP узлов RemRun Toggle соединяются с узлом Lora Loader (LoraManager).
Выход CLIP из LoraManager идет в CLIP Text Encode (Prompt), где пишется текстовый запрос для генерации.
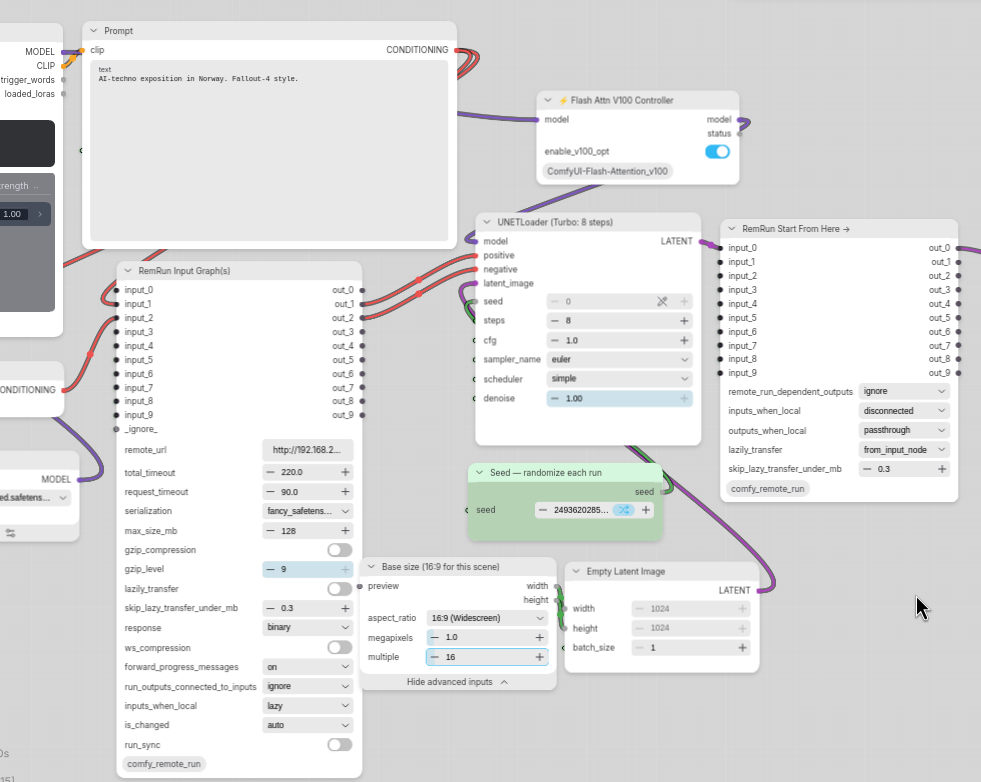
Выходной CONDITIONING из ноды промпта подключается на вход input_0 узла RemRun Input Graph(s).
Выход MODEL из ноды Load LoRA также заводится на вход input_1 этой же ноды отправки.
В поле remote_url вписывается адрес ведомой машины (например, http://192.168.2.41:8188). В поле serialization — fancy_safetensors.
Из выходов out_0 и out_1 ноды RemRun Input Graph(s) потоки данных (модель и готовый кондишен) подключаются напрямую к стандартному локальному Ksampler:
Для выноса VAE выход LATENT из KSampler подключается на вход узла RemRun Start From Here. Выход out_0 из RemRun Start From Here подключается на вход samples стандартного узла VAE Decode (или к его multigpu-версии). Сама нода Load VAE подключается напрямую к VAE Decode. Таким образом ведомая машина сама загрузит у себя VAE и проведет декодирование:
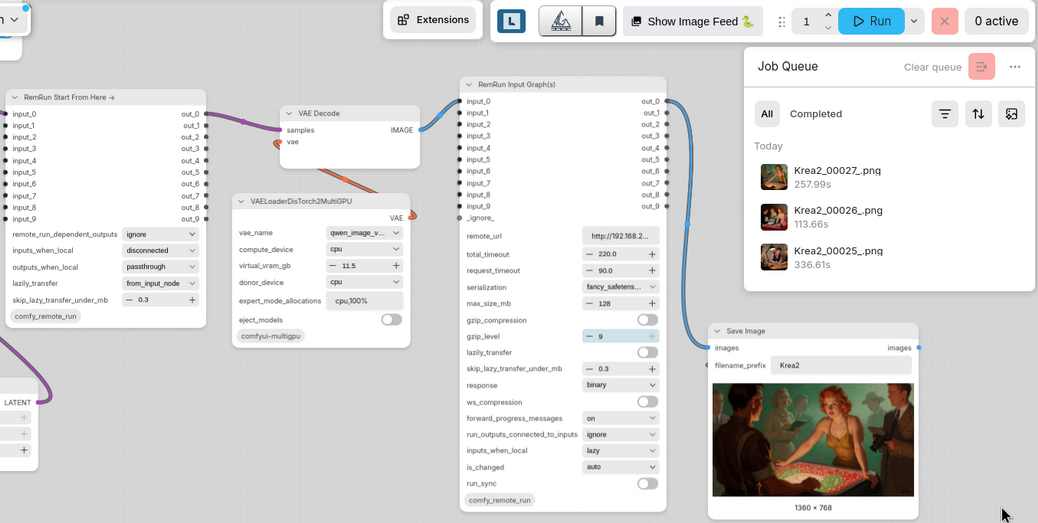
Для возврата картинки на мастер-машину выход IMAGE из VAE-декодера подключается во вторую ноду Remote Run Input Graph(s) (вход input_0).
Все используемые модели (UNET, CLIP, LoRA, VAE) на ведомой машине должны лежать в тех же папках (models/configs/, models/loras/ и т.д.) и иметь те же имена файлов, что и на мастере.
Сетевые адреса в их полях, включая порты, должны соответствовать ведомому компьютеру.
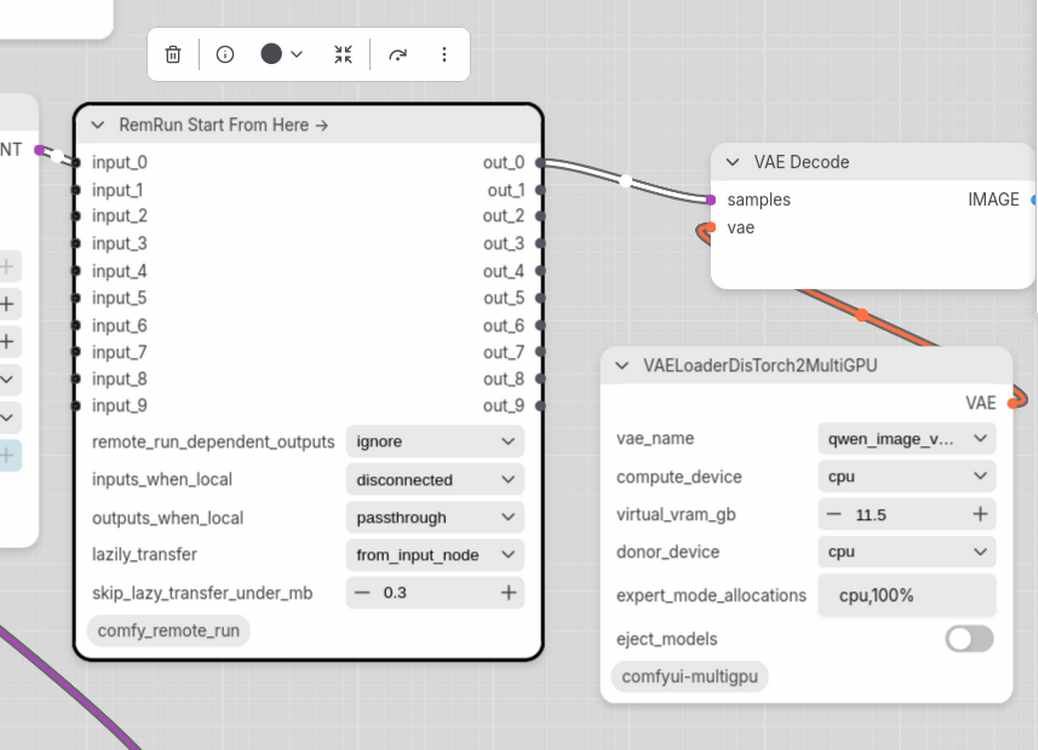
Одним из многочисленных подводных камней, с которым пришлось столкнуться при настройке этого воркфлоу — конфликты кастомных нод, в частности менеджера метаданных comfyui-lora-manager). Для запуска без ошибок пришлось включить параметр passthrough в поле outputs when local ноды RemRun Start From Here:
Во время работы:
- На ведомой машине в роли удаленного вычислительного сервера (воркера) запускается ComfyUI, при этом там не требуется запускать никаких воркфлоу;
- На мастере в ComfyUI запускается рабочее окружение, в котором через ноду RemRun Toggle задается машина, на которой будут вычисляться CLIP, VAE и LORA: локально (only_locally) или удаленно (only_remotely) на ведомом компьютере.
- Узлы RemRun Input Graph(s) упаковывают выбранную часть схемы (модели, промпты) и отправляют этот «суб-граф» на выполнение по сети.
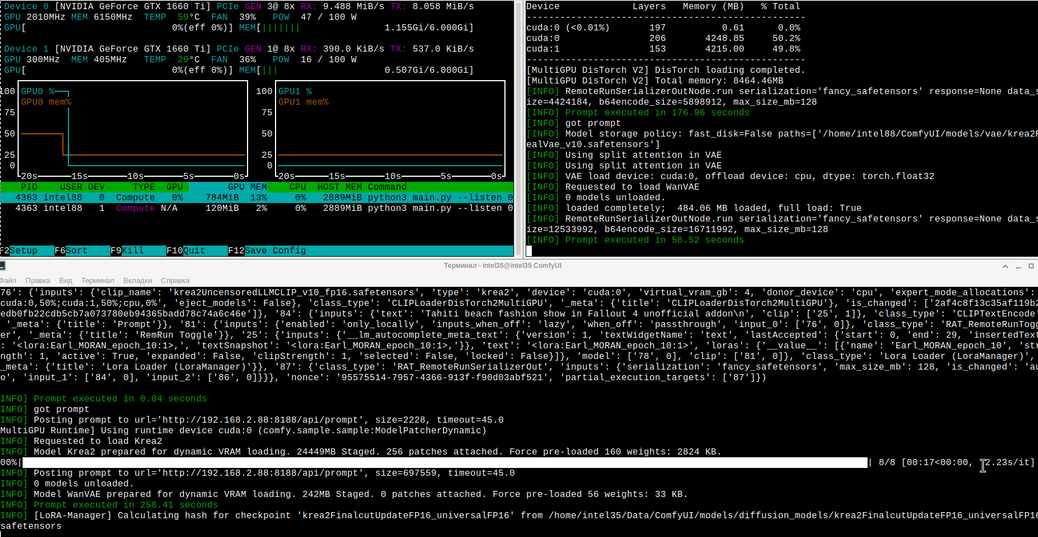
При первом запуске этого воркфлоу требуется много времени для инициализации и загрузки моделей с диска, поэтому в полях узлов RemRun Input Graph(s) нужно задать соответствующие total_timeout и request_timeout.
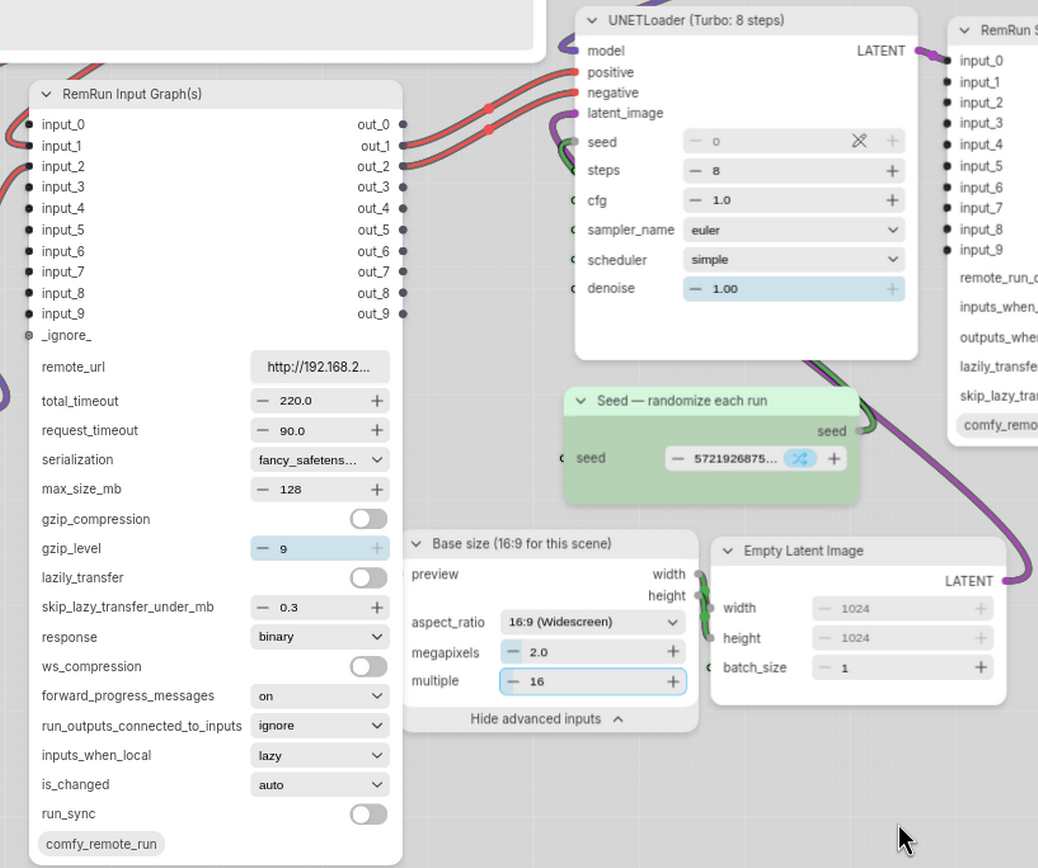
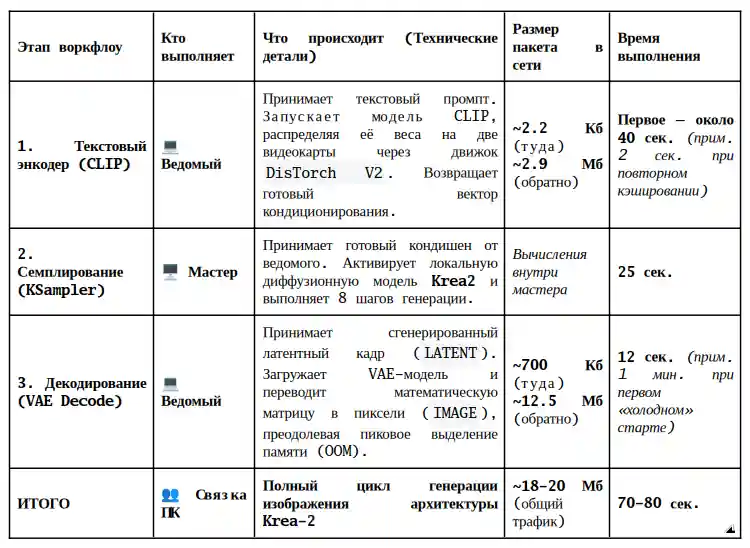
Процесс работы в данном воркфлоу разбивается на три этапа и включает в себя два независимых сетевых обращения к ведомой машине (генерация одной картинки разрешением 1424×800 точек с использованием LORA):
Этап воркфлоу | Кто выполняет | Что происходит (Технические детали) | Размер пакета в сети | Время выполнения |
1. Текстовый энкодер (CLIP) | 💻 Ведомый | Принимает текстовый промпт. Запускает модель CLIP, распределяя её веса на две видеокарты через движок DisTorch V2. Возвращает готовый вектор кондиционирования. | ~2.2 Кб (туда)
| Первое — около 40 сек. (прим. 2 сек. при повторном кэшировании) |
2. Семплирование (KSampler) | 🖥️ Мастер | Принимает готовый кондишен от ведомого. Активирует локальную диффузионную модель Krea2 и выполняет 8 шагов генерации. | Вычисления внутри мастера | 25 сек. |
3. Декодирование (VAE Decode) | 💻 Ведомый | Принимает сгенерированный латентный кадр (LATENT). Загружает VAE-модель и переводит математическую матрицу в пиксели (IMAGE), преодолевая пиковое выделение памяти (OOM). | ~700 Кб (туда)
| 12 сек. (прим. 1 мин. при первом «холодном» старте) |
ИТОГО | 👥 Связка ПК | Полный цикл генерации изображения архитектуры Krea-2 | ~18-20 Мб (общий трафик) | 70-80 сек. |
Вместо заключения
При настройке рабочего окружения и работе с расширением comfy_remote_run в comfyui выяснилось, что оно хорошо сочетается с другими кастомными нодами, включая CLIPLoaderDisTorch2MultiGPU. Этот узел нужно настроит так, чтобы правильно распределить VRAM. Для этого задействуется строка экспертных настроек (expert_mode_allocations), куда нужно вписать данные о распределении весов, например: cuda:0,50%;cuda:1,50%;cpu,0%. Строку donor_device трогать не нужно, так конфигурация устройств на мастере и ноде не всегда одинаковая:
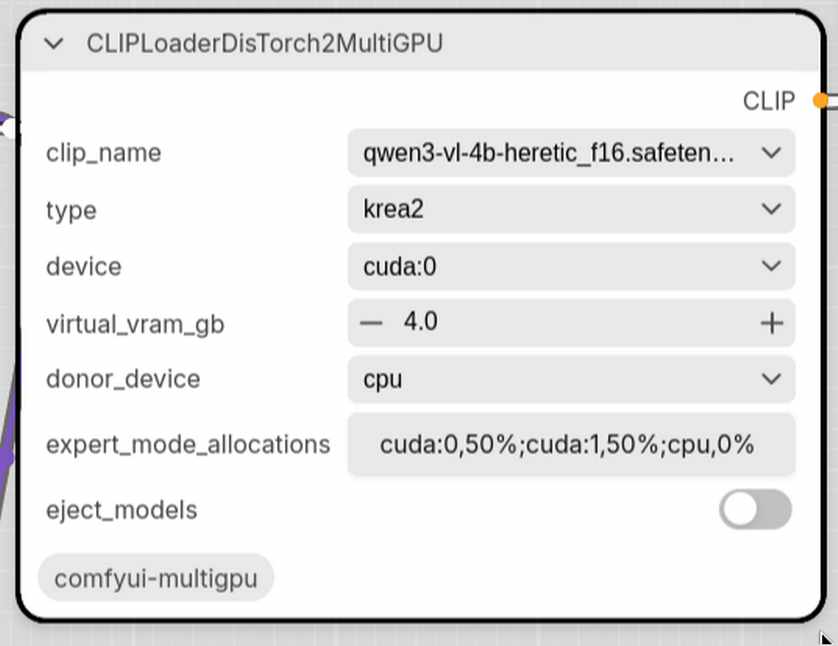
При попытке запустить воркфлоу с неверно заполненным полем device (например, указать там отсутствующую на мастере карту cuda:1), появляется ошибка Invalid input. The value cuda:1 for UNETLoaderDisTorch2MultiGPU’s donor_device is not available.
При выносе на удаленную машину с ограниченным объемом VRAM текстового энкодера, LORA и VAE не получается постоянно оставлять их в памяти видеокарт из-за пиковых нагрузок при вычислениях VAE. Для обеспечения стабильности приходиться либо использовать аргумент запуска highvram (вместо gpu-only), либо использовать опцию lowvram, либо вообще разносить CLIP и VAE на разные ведомые инстанции (если позволяет локальная сеть).
Передача данных по локальной сети при выносе CLIP , LORA и VAE занимает доли секунды. Даже самый тяжелый пакет — возврат готовой несжатой картинки от ведомого на мастер — весит всего 12.5 Мб, что позволяет использовать такую схему даже при 100Mbit-соединении или стабильном Wi-Fi.
Благодаря выносу CLIP (8.4 Гб) , LORA (0.5Гб) и VAE (0.4Гб) на основном компьютере сэкономлено почти 10 Гб VRAM, что весомо (до десятков секунд) увеличило быстродействие при работе с изображениями.

Вам также может понравиться
О конвертации тензорных AI-моделей в квантованный формат
Распределение веса модели в памяти двух видеокарт в stable-diffusion.cpp