О конвертации тензорных AI-моделей в квантованный формат
Для локальной работы с диффузионными AI-моделями часто требуется большое количество видеопамяти. Для решения этой проблемы на компьютерах с GPU с недостаточным объемом памяти можно использовать квантизированные версии тех же моделей. Они имеют значительно меньший размер за счет небольшого снижения точности и качества, с чем можно смириться, получив рабочую конфигурацию, подходящую для практического использования.
Сжать ИИ-модель до нужного кванта (размера) можно самостоятельно, используя расширения comfyui, python-скрипты, а также программу sd-cli из бэкенда stable-diffusion.cpp (гайд по установке в gentoo linux ниже по тексту). Этот проект является реализацией инференса различных диффузионных моделей (например, Stable Diffusion 1.x/2.x/XL/3.x, FLUX, Wan, Qwen Image, Z-Image, Krea-2 и др.) на C/C++. sd.cpp может работать как с полновесными моделями в формате .ckpt и .safetensors, так и с GGUF-версиями нужной битности.
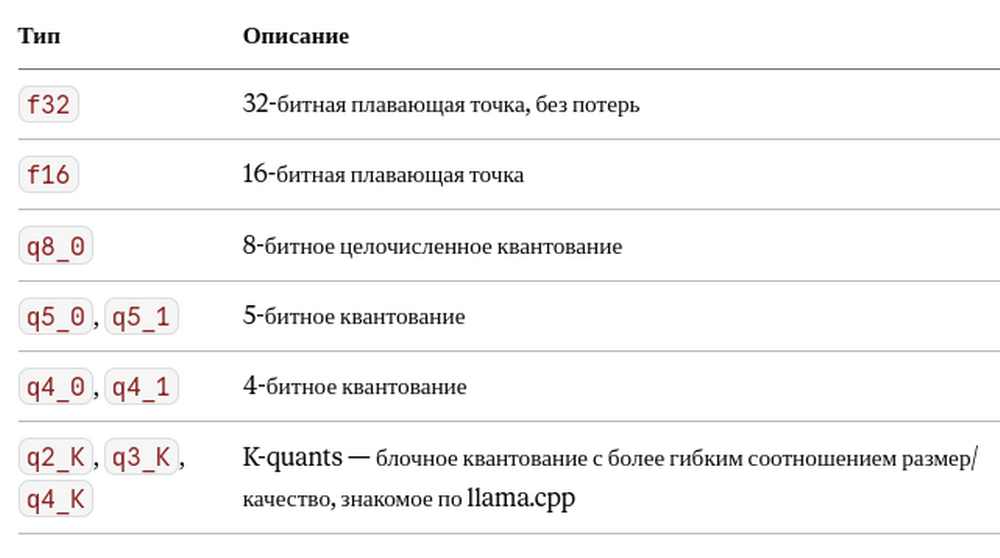
Типы весов при конвертации ИИ-моделей в sd.cpp:
Для конвертации на компьютере должно быть достаточно оперативной памяти для хранения весов модели. В противном случае нужно использовать один из трех способов, экономящих потребление RAM:
- выгрузка в файл подкачки;
- стриминговая (поочередная) склейка;
- конвертация в comfyui (расширение ComfyUI-GGUF).
Если нужно получить эффективно работающую сжатую диффузионную модель, стоит выбирать формат модели, поддерживаемый видеокартой на аппаратном уровне. Например, на потребительских картах Nvidia GeForce GTX 1000-й серии очень хорошо выполняются FP32-операции, при этом их FP16-производительность снижена в 64 раза (!) по сравнению с 32-разрядными вычислениями. К сожалению, конвертация большинства AI-моделей в этот формат для этих карт нецелесообразна, так как требует в два раза большего количества VRAM в сравнении с FP16, а ее на них итак очень мало. Наиболее подходящими инструкциями для этих видеокарт являются INT8. Это векторные инструкции DP4A (сокращение от Dot Product 4 Add), при выполнении которых за один такт GPU одновременно выполняет четыре операции над 8-битными целыми числами.
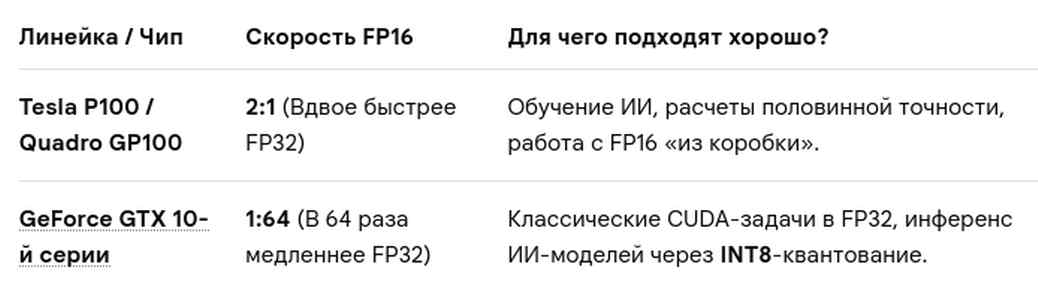
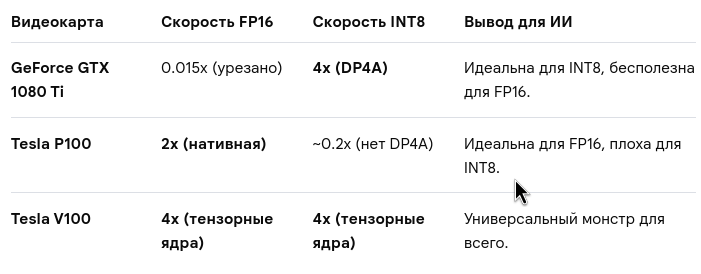
Это позволяет осуществлять AI-вычисления с высокой скоростью даже на GPU десятилетней давности. Б.у. серверные видеокарты Nvidia Tesla V100 также поддерживают скоростные INT8-команды, поэтому они отлично подходят для совместной работы в кластере с бытовыми Pascal-ями. Tesla P100 плохо подходит для работы с INT8, но зато хорошо справляется с FP16.
Сравнение скорости нейросетевых вычислений для инструкций FP16 и INT8 в сравнении с FP32 для GPU Nvidia поколений Pascal-Volta:
К сожалению, INT8-операции имеют меньшую математическую точность в сравнении с FP16, что отрицательно влияет на качество нейросетевых вычислений. Формат INT8 содержит всего 256 возможных значений (от -128 до 127), в то время как FP16 — это числа с плавающей запятой, покрывающие огромный диапазон. Поэтому перевод модели из FP16 в INT8 (квантование) приводит к потере точности (ошибкам округления). Это не критично для простых задач (распознавание лиц, классификация картинок), но существенно для сложных операций (генерация текста и картинок), при выполнении которых могут значительно ухудшаться ответы в языковых моделях, или появляться артефакты при генерации картинок.
Для практического использования INT8-команд при работе с нейросетевыми моделями в llama.cpp, sd.cpp и подобных программах применяется более продвинутый формат — квантование Q8_0. При этом веса нейросети упаковываются в целые 8-битные числа, используя специальный блочный формат, в котором:
- веса модели хранятся как 8-битные целые числа, что позволяет уменьшить размер модели в 2 раза по сравнению с FP16.
- веса модели разбиваются на небольшие блоки (обычно по 32 веса в одном блоке) с общим коэффициентом масштабирования в формате FP16 (дельта).
- при вычислениях, чтобы получить реальное значение веса берется 8-битное число (INT8) из блока и умножается на коэффициент масштабирования в формате FP16.
Благодаря использованию этой технологии значительно увеличивается точность вычислений в сравнении с чистым INT8. Так как каждые 32 веса модели имеют собственный плавающий коэффициент, качество ответов Q8-нейросети (метрика perplexity) отличается от оригинальной FP16-модели лишь на сотые доли процента.
Попытка DIY-конвертации диффузионной AI-модели в формат GGUF скриптом от stable-diffusion.cpp
Для конвертации нейросетевой модели в формате *.safetensors в другой формат, включая gguf, в stable-diffusion.cpp теоретически можно использовать клиентское приложение sd-cli, или скрипты, находящиеся в папке /scripts/ с исходниками stable-diffusion.cpp.
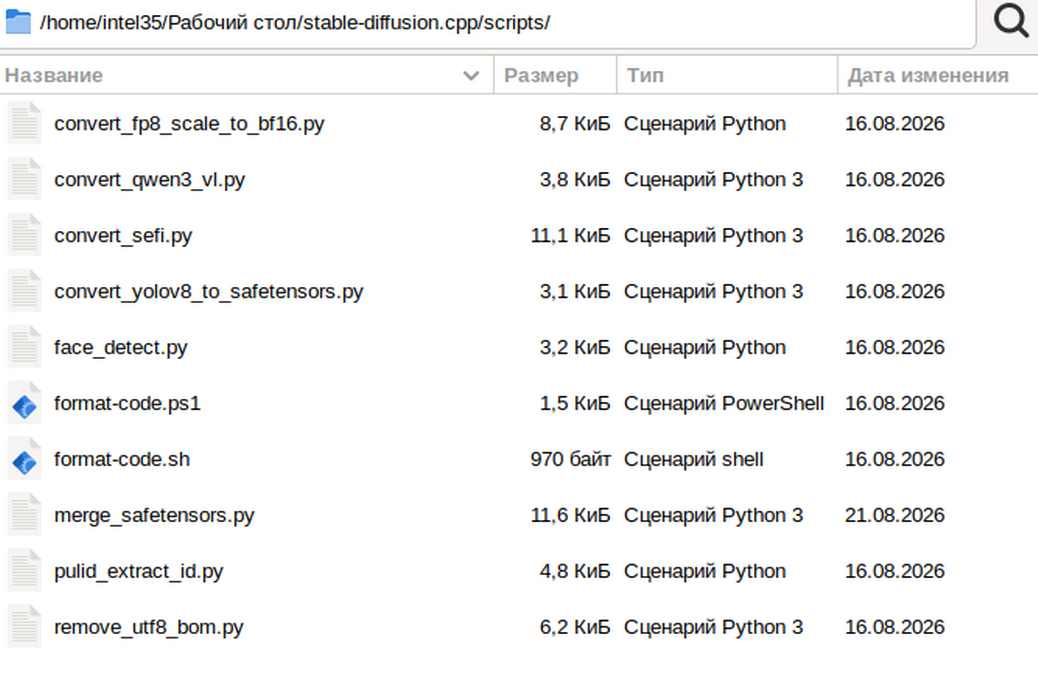
Для модели Z-Image, построенной на базе архитектуры Qwen3-VL-4B-Instruct можно использовать скрипт convert_qwen3_vl.py.
Конвертация нейросетевой модели в sd-cli выполняется комнадой вида
./sd-cli -M convert --convert-name \

-m $HOME/AI_Models/z_image_bf16.safetensors \

-o $HOME/AI_Models/z_image_base-FP16.gguf \

-v --type f16
У автора данной статьи работа программы по этой команде при конвертации разных моделей «завершалась успешно», но получаемый файл либо падал при запуске с ошибкой разметки метаданных, либо «успешно» генерировал одноцветный пустой холст:
Конвертация Z-Image-Base с помощью скрипта convert_qwen3_vl.py в формат FP16 завершилась более успешно, так как он специально создан для конвертации моделей Qwen3-VL HF safetensors checkpoint в совместимый с sd.cpp формат (BF16/F16/F32). Последовательность действий по конвертации в FP16:
- скачиваем диффузионную модель Z-Image-Base с huggingface (bf16-версия от Comfy-Org весит 12.3GB):
- создаем или запускаем ране созданное виртуальное окружение Python. Автором для конвертации использовалось venv-окружение comfyui, после запуска которого нужно перейти в папку со скриптами sd.cpp, откуда уже запускать конвертацию. Для создания z_image_base-F16.gguf использовалась команда:
cd $HOME/"Рабочий стол"/Data/ComfyUI/ && source ./venv/bin/activate

cd $HOME/"Рабочий стол"/stable-diffusion.cpp/scripts/

python3 convert_qwen3_vl.py \

"$HOME/AI_Models/z_image_bf16.safetensors" \

"$HOME/AI_Models/z_image_base-F16.gguf"
Лог конвертации z_image_bf16.safetensors (453 тензора) в z_image_base-FP16.gguf скриптом convert_qwen3_vl.py:
Tensors: 453
Writing -> /home/intel35/AI_Models/z_image_base-F16.gguf
Done. Output size: 12.31 GB
Файл z_image_base-FP16, полученный в результате конвертации, имеет такой же размер, как и оригинальный BF16 (11.5GB), не является gguf-файлом и на Tesla V100 работает также медленно, как и BF16-исходник. При более внимательном изучении скрипта convert_qwen3_vl.py, выяснилось, что он использует библиотеку safetensors.torch.save_file или torch.save, а не gguf.GGUFWriter. Поэтому в полученном файле сохранены тензоры safetensors/pytorch, в заголовке нет метки GGUF.
Для конвертации в FP16-формат делались попытки использовать сторонние скрипты конвертации, например, pack_and_quantize_FP16.py :
import sys
import os
import torch
from safetensors.torch import load_file, save_file
def safe_bf16_to_fp16(tensor, key_name):
# Превращаем в FP32 для точных проверок
t_fp32 = tensor.to(torch.float32)
FP16_MAX = 65504.0
FP16_MIN = -65504.0

max_val = t_fp32.max().item()
min_val = t_fp32.min().item()

if max_val > FP16_MAX or min_val < FP16_MIN:
    print(f" [!] Тензор за границами FP16: {key_name} (Max: {max_val:.1f}, Min: {min_val:.1f})")
    # Безопасно ограничиваем значения вместо уничтожения масштаба весов
    t_fp32 = torch.clamp(t_fp32, min=FP16_MIN, max=FP16_MAX)
    print(f"  -> Применено жесткое ограничение (clipping) до границ FP16")

return t_fp32.to(torch.float16)
def main():
if len(sys.argv) < 3:
print(«Использование: python convert_bf16_to_safe_fp16.py <input_bf16.safetensors> <output_fp16.safetensors>»)
sys.exit(1)
input_path = sys.argv[1]
output_path = sys.argv[2]

if not os.path.exists(input_path):
    print(f"[-] Файл не найден: {input_path}")
    sys.exit(1)

print(f"[*] Загрузка оригинальных BF16 весов...")
state_dict = load_file(input_path)
new_state_dict = {}

print("[*] Конвертация слоев...")
for key, tensor in state_dict.items():
    new_state_dict[key] = safe_bf16_to_fp16(tensor, key)

print(f"[*] Сохранение FP16-safetensors файла...")
save_file(new_state_dict, output_path)
print(f"[+] Успех! Файл сохранен: {output_path}")
if name == «main»:
main()
Он запускается в виртуальном окружении, например:
cd $HOME/"Рабочий стол"/Data/ComfyUI/ && source ./venv/bin/activate

cd $HOME/"Рабочий стол"/stable-diffusion_cpp/

python3 pack_and_quantize_FP16.py \

"$HOME/AI_Models/z_image_bf16.safetensors" \

"$HOME/AI_Models/z_image_base-F16.gguf"
Полученный файл z_image_bf16.safetensors благодаря поддержке FP16-инструкций на Nvidia Tesla V100 работает почти в 4 раза быстрее, чем исходный BF16-й формат, но может некорректно отработать веса модели. Для более надежного квантования нейросетевой модели в Q8 или другой формат нужно использовать python-скрипт, использующий библиотеку gguf плюс выборочное квантование (Mixed-Precision Quantization), сохраняющее нетронутыми самые важные веса, например, скриптом pack_and_quantize_Q8.py:
import sys
import os
import torch
from safetensors.torch import load_file
import gguf
def main():
if len(sys.argv) < 3:
print(«Использование: python pack_to_gguf_fp16.py <input_bf16.safetensors> <output_F16.gguf>»)
sys.exit(1)
input_path = sys.argv[1]
output_path = sys.argv[2]

if not os.path.exists(input_path):
    print(f"[-] Файл не найден: {input_path}")
    sys.exit(1)

print(f"[*] Загрузка исходных тензоров из: {input_path}")
state_dict = load_file(input_path)

# Инициализируем GGUF Writer
# Архитектура "qwen3_vl" или любая другая валидная для вашего инференса
writer = gguf.GGUFWriter(output_path, arch="qwen3_vl")

print("[*] Запись метаданных формата GGUF...")
writer.add_architecture()
writer.add_bool("model.diffusion_model", True)
writer.add_string("model.name", "Z-Image S3-DiT Mixed-Precision Base")

print("[*] Перенос тензоров в формат GGUF (все веса приводятся к FP16/FP32)...")
for key, tensor in state_dict.items():
    # В GGUF веса нормализации и bias лучше хранить в FP32 для стабильности
    if "norm" in key.lower() or "bias" in key.lower():
        print(f"  [F32] Сохранение точности -> {key} {list(tensor.shape)}")
        data_np = tensor.to(torch.float32).numpy()
    else:
        print(f"  [F16] Конвертация матрицы  -> {key} {list(tensor.shape)}")
        data_np = tensor.to(torch.float16).numpy()

    # Корректное добавление тензора в пул сборщика
    writer.add_tensor(key, data_np)

# Финализируем сборку (GGUFWriter сам соберет заголовки и выстроит выравнивание данных)
print("[*] Запись GGUF файла на диск...")
writer.write_header_to_file()
writer.write_kv_data_to_file()
writer.write_tensors_to_file()
writer.close()

print(f"[+] Успех! Создан валидный базовый GGUF: {output_path}")
print(f"    Итоговый размер: {os.path.getsize(output_path) / (1024**3):.2f} GB")
print(f"\n[*] Чтобы получить идеальный Q8_0 с автоматической защитой слоев нормализации, выполните:")
print(f"    llama-quantize {output_path} {output_path.replace('.gguf', '_Q8_0.gguf')} q8_0")
if name == «main»:
main()
Он также отрабатывает в виртуальном окружении:
cd $HOME/"Рабочий стол"/Data/ComfyUI/ && source ./venv/bin/activate

cd $HOME/"Рабочий стол"/stable-diffusion_cpp/

python3 pack_and_quantize_Q8.py \

"$HOME/AI_Models/z_image_bf16.safetensors" \

"$HOME/AI_Models/z_image_base-Q8.gguf"
В ряде случаев конвертация происходит неудачно, ломает математику работы модели, что проявляется в генерации артефактов и других проблемах. Чтобы избавиться от мучений при конвертации, в большинстве случаев лучше взять готовую работающую gguf-модель или конвертировать базовую в подходящий формат с помощью comfyui…
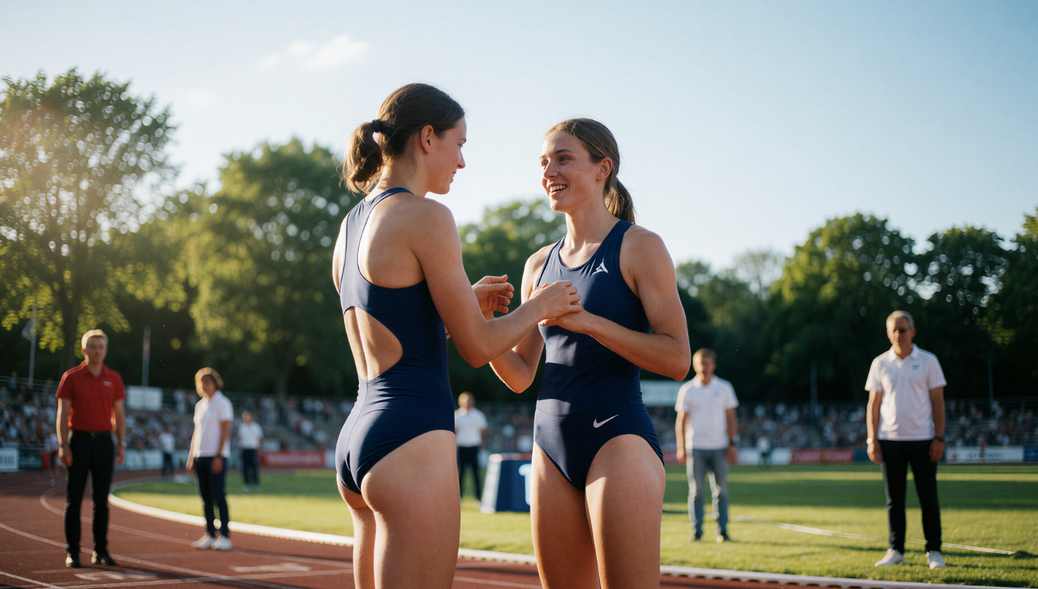
Генерация по промту «Сделай веселую картинку на тему: Европейские спортсмены опять потерпели поражение…» в ComfyUI, модель Krea2-Turbo-FP8.safetensors + Qwen3-VL-2B-Instruct + ComfyUI-SeedVR2_VideoUpscaler:
Шпаргалка по установке sd.cpp в linux (на примере gentoo linux)
Ставим служебные пакеты и библиотеки:
sudo emerge -av dev-vcs/git dev-build/cmake sys-devel/gcc media-libs/libwebp media-libs/libpng media-libs/libjpeg-turbo
sudo emerge -av x11-drivers/nvidia-drivers dev-util/nvidia-cuda-toolkit
Если планируется использовать InfiniBand и Remote Direct Memory Access (RDMA), ставим rdma-core:
sudo emerge -av sys-cluster/rdma-core
Для multi-GPU и кластерных систем с Nvidia собираем нативную версию NCCL или устанавливаем готовые бинарники. Их можно скачать с сайта https://developer.nvidia.com/w/compute/redist/nccl/.
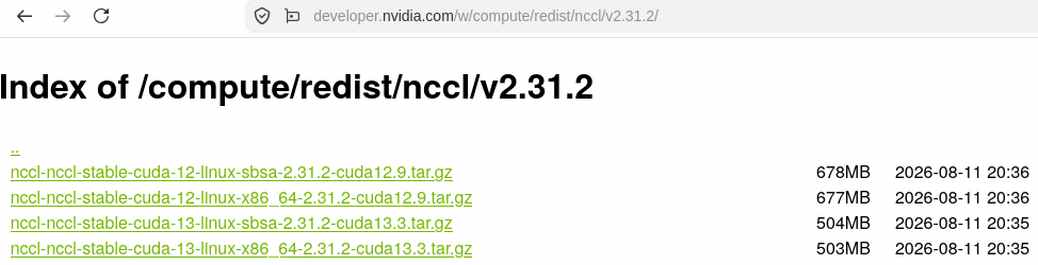
Выбираем версию, подходящую для своей видеокарты/CUDA Toolkit, например, для версии nccl-nccl-stable-cuda-12-linux-x86_64-2.31.2-cuda12.9.tar.gz:
- скачиваем архив с файлами nccl:
wget https://developer.nvidia.com/w/compute/redist/nccl/v2.31.2/nccl-nccl-stable-cuda-12-linux-x86_64-2.31.2-cuda12.9.tar.gz
- извлекаем из него файлы:
tar -xvf nccl-nccl-stable-cuda-12-linux-x86_64-2.31.2-cuda12.9.tar.gz
cd nccl-nccl-stable-cuda-12-linux-x86_64-2.31.2-cuda12.9
- копируем заголовочные файлы и библиотеки в системные папки:
sudo cp -rv include/* /usr/local/include/
sudo cp -rv lib/* /usr/local/lib/
- обновляем кэш линкера:
sudo ldconfig
- проверяем правильность установки nccl:
ldconfig -p | grep nccl
Для сборки stable-diffusion.cpp с поддержкой интерфейса в интернет-браузере, устанавливаем инструменты веб-разработки Node.js и pnpm:
sudo emerge --ask net-libs/nodejs && sudo npm install -g pnpm
Скачиваем stable-diffusion.cpp:
git clone --recursive https://github.com/leejet/stable-diffusion.cpp && cd stable-diffusion.cpp
или обновляем папку с исходниками:
cd stable-diffusion.cpp && git pull origin master && git submodule update —init —recursive
Собираем исполняемые файлы stable-diffusion.cpp под свою архитектуру:
rm -rf build && cmake -B build -DCMAKE_BUILD_TYPE=Release -DBUILD_SHARED_LIBS=OFF -DSD_RPC=ON -DGGML_CUDA=ON -DGGML_CUDA_VMM=ON -DCMAKE_INTERPROCEDURAL_OPTIMIZATION=ON -DGGML_NCCL=ON -DGGML_CCACHE=OFF -DCMAKE_CUDA_ARCHITECTURES=native -DCMAKE_C_COMPILER=/usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc -DCMAKE_CXX_COMPILER=/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++ -DCMAKE_C_FLAGS="-O3 -march=native -pipe -fno-semantic-interposition" -DCMAKE_CXX_FLAGS="-O3 -march=native -pipe -fno-semantic-interposition" -DCMAKE_CUDA_FLAGS="-O3 -lto_native --allow-unsupported-compiler -ccbin /usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc -Wno-deprecated-gpu-targets" && cmake --build build -j$(nproc)
Готовые файлы sd-cli и sd-server создаются в папке /build/bin/.


Вам также может понравиться

Запуск AI-моделей в llama.cpp на AMD Radeon RX470 8GB с Vulkan в gentoo

Компиляция и работа с llama.cpp для GPU Nvidia в linux