Вынос clip, vae и lora на другой компьютер в comfyui
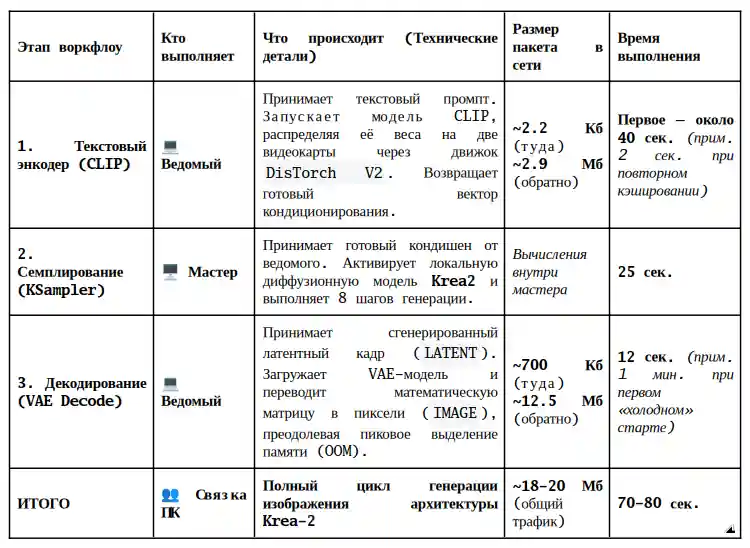
Современная генеративно-диффузионная индустрия развивается стремительно, но у этого прогресса есть обратная сторона — колоссальный рост системных требований. Такие DiT-модели, как Flux, Krea-2, SD3 и другие, требуют десятки гигабайт VRAM для загрузки весов, контекста и работы апскейлера, что часто приводит к необходимости жертвовать качеством ради возможности вообще запустить рабочий процесс. Пытаясь запустить воркфлоу с современной AI-моделью на среднем или слабом домашнем компьютере, пользователь неизбежно сталкивается с торможением, вызванным постоянной загрузкой-выгрузкой больших файлов в память видеокарты/ОЗУ, необходимостью очищать кэш и вылетами по ошибке OOM (Out Of Memory). На первый взгляд, самым простым решением этой проблемы является покупка новой мощной и дорогой видеокарты. Однако, это не всегда приемлемо по разным причинам. Проблему можно…
Расширение возможностей comfyui за счет ресурсов локальной сети
При работе c локальными AI-приложениями обычно требуется большое количество быстрой видео или хотя бы оперативной памяти. По ряду причин не всегда есть возможность нарастить имеющиеся аппаратные возможности, требующиеся, например, для запуска бэкенда comfyui. Иногда необходимый ресурс можно получить без особых затрат, используя распределение нагрузки между компьютерами, находящимися в одной локальной сети. Такой подход позволяет освободить как вычислительную мощь, так и память основного (управляющего) компьютера, переложив выполнение ряда операций на другие машины. За счет этого, как мимнимум, сокращается время, затарачиваемое на периодическую загрузку-выгрузку объемных нейросетевых моделей при работе с изображениями, видео, звуком и в других случаях. В comfyui это можно сделать, добавляя различные вспомогательные узлы в рабочем окружении. Например, для разгрузки…
О конвертации тензорных AI-моделей в квантованный формат
Для локальной работы с диффузионными AI-моделями часто требуется большое количество видеопамяти. Для решения этой проблемы на компьютерах с GPU с недостаточным объемом памяти можно использовать квантизированные версии тех же моделей. Они имеют значительно меньший размер за счет небольшого снижения точности и качества, с чем можно смириться, получив рабочую конфигурацию, подходящую для практического использования. Сжать ИИ-модель до нужного кванта (размера) можно самостоятельно, используя расширения comfyui, python-скрипты, а также программу sd-cli из бэкенда stable-diffusion.cpp (гайд по установке в gentoo linux ниже по тексту). Этот проект является реализацией инференса различных диффузионных моделей (например, Stable Diffusion 1.x/2.x/XL/3.x, FLUX, Wan, Qwen Image, Z-Image, Krea-2 и др.) на C/C++. sd.cpp может работать как с полновесными моделями…
Криптовалюта Soteria (SOTER), майнинг на алгоритме soterg
Soteria Network (SOTER) — это форк биткоина с собственным PoW хеш-алгоритмом и классическим GPU-майнингом в адаптированном ccminer. Не стоит путать Soteria с другими, никак не связанными друг с другом проектами: В этой статье речь идет о PoW-сети Soteria Network (официальный сайт soteria-network в домене online, GitHub-репозиторий Soteria-Network). Интерес к написанию статьи об этой монете вызван желанием собрать адаптированный под свое железо ccminer (для тестирования возможностей видеокарты Nvida Tesla V100). Что такое Soteria Network? Soteria Network — это UTXO-блокчейн, построенный на кодовой базе Bitcoin Core с оглядкой на криптовалюту Ravencoin (RVN). Анонимные разработчики SOTER в качестве основы используют традиционную модель транзакций с добавлением слоя управления активами. Несмотря на анонимность создателей, у…
Криптовалюта AlphaNumeric (ALPHA), майнинг на алгоритме blake3_an
В майнерских кругах появление нового алгоритма майнинга обычно вызывает всплеск интереса к связанной с ним монете. В последней версии SRBMiner-Multi появился алгоритм blake3_an (криптовалюта AlphaNumeric (ALPHA, она же ALP или AL), поддерживается в srbminer-multi 3.5.7+, fee 2.00%, вычисления на видеокартах AMD, Nvidia и Intel). На первый взгляд этот актив выглядит как очередной ноунейм-коин, клонирующий широко известный BLAKE3. В данной статье делается попытка разобраться, что это за монета — AlphaNumeric (тикер ALP), чем её алгоритм отличается от «классического» BLAKE3 (Alephium), и как поднять майнинг этого шиткоина в домашнем кластере. AlphaNumeric — это молодой, нишевый проект. У него нет листингов на крупных биржах, но он реально майнится на некоторых пулах, используя свой…
Как преобразовать нейросетевую модель в другой формат в llama.cpp
Конвертация ИИ-моделей в экосистеме llama.cpp выполняется в два этапа: Пример команды для конвертации модели в формат FP16: python convert_hf_to_gguf.py /path/to/hf/model/ —outtype f16 —outfile model_f16.gguf На втором этапе полученный тяжелый файл GGUF сжимается (квантуется) до нужного уровня битности с помощью инструмента llama-quantize из каталога с собранными файлами llama.cpp (по умолчанию это папка llama.cpp/build/bin). Пример команды для создания кванта Q4_K_M: ./llama-quantize model_f16.gguf model_q4_km.gguf q4_k_m Такой двухэтапный процесс позволяет сначала получить точную копию модели в едином контейнере GGUF, а затем быстро нарезать её на кванты любой нужной битности под конкретные ограничения видеопамяти. Практический пример: конвертация и оптимизация модели Qwen3.8-27B под старое железо Qwen3.8-27B — современная плотная (Dense) vision-language модель на 27 млрд. параметров…
О квантовании AI-моделей для локального инференса
Оригинальные AI-модели от разработчиков обычно публикуются в весах FP16 или BF16. При этом модели имеют довольно большой объем, например, Qwen2.5-VL-72B-Instruct весит примерно 147 ГБ. Конвертация AI-моделей в сжатый формат (квантование), например, в GGUF позволяет запустить эту модель локально на обычном потребительском оборудовании. Правильно подобранный формат модели значительно снижает требования к VRAM и оперативной памяти, помогает оптимизировать процесс вычислений под конкретные аппаратные инструкции. Например, квантованная до 4 бит версия Qwen2.5-VL-72B-Instruct уменьшается в размере до 40-50 ГБ, позволяя запустить её на более доступном железе, в том числе в небольшой домашней сети под управлением llama.cpp. Учитывая большое количество существующих форматов сжатия ИИ-моделей, иногда сложно разобраться, какой из них следует выбрать под свое оборудование.…
Запуск llama.cpp на Nvidia Tesla K40 на Vulkan
Эта статья является продолжением эпопеи с выжиманием AI-соков из старой серверной видеокарты Nvidia Tesla K40, начатой в статьях «Локальный ИИ на Nvidia Tesla K40: сборка и настройка компьютера» и «Запуск llama.cpp на Nvidia Tesla K40».В данном материале описываются результаты работы по сборке бэкенда llama.cpp для Nvidia Tesla K40 под Vulkan. Такой вариант интересен своей универсальностью. При этом не требуется модификация исходников llama.cpp, отвечающих за работу с CUDA, что значительно упрощает не только процесс сборки, но и уменьшает вероятность появления сбоев при работе в составе кластера. Основной проблемой в этом случае является относительно устаревшая версия Vulkan 1.2.175, аппаратно поддерживаемая Nvidia Tesla K40m: Сборка llama.cpp из исходного кода под Vulkan Для сборки…
Запуск llama.cpp на Nvidia Tesla K40 на CUDA
Эта статья является продолжением руководства «Локальный ИИ на Nvidia Tesla K40: сборка и настройка компьютера», в котором описывается настройка операционной системы ubuntu-server 26.04 для работы с патченными драйверами Nvidia 470-й версии. В ней изложена последовательность действий, необходимых для: В конце статьи приведены примеры работы видеокарты Nvidia Tesla K40 с языковыми AI-моделями локально и в составе небольшого кластера с подключением по 2.5Gbit каналу. Развертывание Cuda Toolkit 11.8 в ubuntu 26.04 Установка Cuda Toolkit 11.8 и необходимых для ее работы служебных файлов: wget https://developer.download.nvidia.com/compute/cuda/11.8.0/local_installers/cuda_11.8.0_520.61.05_linux.runsudo sh cuda_11.8.0_520.61.05_linux.run --extract=$HOME/cuda_extractedsudo mkdir -p /usr/local/cuda-11.8/binsudo mkdir -p /usr/local/cuda-11.8/lib64sudo mkdir -p /usr/local/cuda-11.8/includecd $HOME/cuda_extracted Запускаем скрипт, который находит исполняемые файлы инсталляторов внутри папок и распаковывает их в /usr/local/cuda-11.8: for…
Локальный ИИ на Nvidia Tesla K40: сборка и настройка компьютера
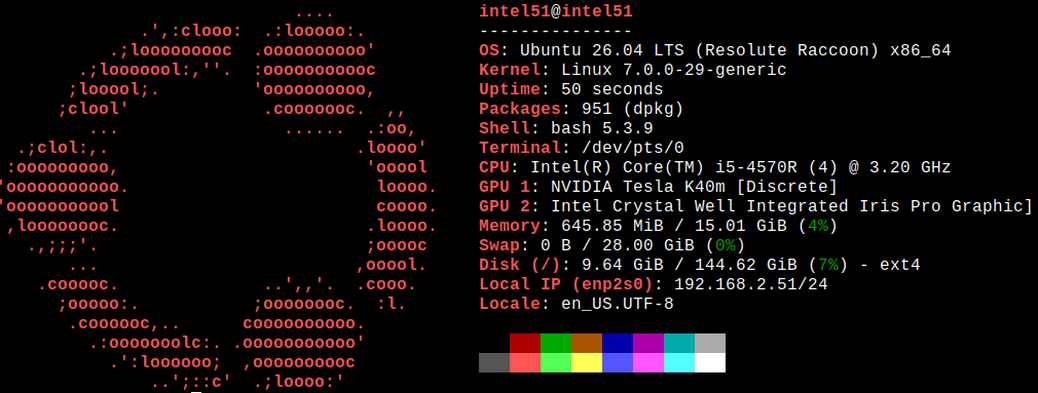
Высокие цены на видеокарты и память ограничивают возможности многих желающих локально запускать средние и большие модели ИИ. В связи с этим, при ограниченном бюджете, вызывает интерес возможность использования старых серверных видеокарт.В данной статье рассматриваются возможности инференса и генерации изображений на старой видеокарте Nvidia Tesla K40M с 12GB VRAM, которая у автора около 10 лет провалялась в дальнем ящике… Для этого использовалась материнская плата ASRock H81 Pro BTC R2.0 с BIOS P1.40 (опция Above 4G Decoding активирована по умолчанию, PCIE1 Link Speed выставлен на максимум для этой платы — в Gen2) + CPU Intel i5-4570R (4C/4T), 16 ГБ RAM DDR3 1600MHz, HDD 500GB и сетевая плата Realtek RTL8125B (2.5GBit). Установка последней…