Расширение возможностей comfyui за счет ресурсов локальной сети
При работе c локальными AI-приложениями обычно требуется большое количество быстрой видео или хотя бы оперативной памяти. По ряду причин не всегда есть возможность нарастить имеющиеся аппаратные возможности, требующиеся, например, для запуска бэкенда comfyui. Иногда необходимый ресурс можно получить без особых затрат, используя распределение нагрузки между компьютерами, находящимися в одной локальной сети. Такой подход позволяет освободить как вычислительную мощь, так и память основного (управляющего) компьютера, переложив выполнение ряда операций на другие машины. За счет этого, как мимнимум, сокращается время, затарачиваемое на периодическую загрузку-выгрузку объемных нейросетевых моделей при работе с изображениями, видео, звуком и в других случаях.
В comfyui это можно сделать, добавляя различные вспомогательные узлы в рабочем окружении. Например, для разгрузки памяти видеокарты можно вынести на другее устройство (устройства) текстовый энкодер и/или диффузионную модель.
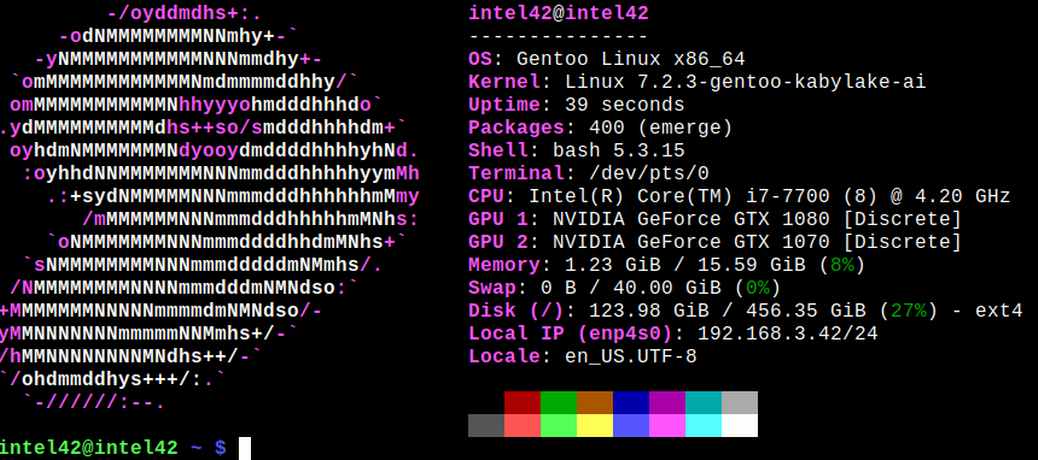
В данной статье частично описывается опыт распределения ресурсов при работе с достаточно сложным workflow для генерации изображений в Krea-2-Turbo на компьютере под управлением gentoo linux в следующей конфигурации:
- диффузионная модель в версиях krea2_turbo_fp8_scaled.safetensors (12.2GB), а также kreamania, варинаты 7 и 8 (объемом 11.9-12.9GB в завсимости от версии);
- текстовый энкодер qwen3vl_4b_fp8_scaled.safetensors (4.9GB);
- LLM-улучшение промта в Qwen3-VL-2B-Instruct (4GB);
- улучшение картинки в SeedVR2 (seedvr2_ema_7b_fp16.safetensors, 15.3GB плюс ema_vae_fp16.safetensors 478MB);
- модуль qwen_image_vae.safetensors (242MB).
Минимальный объем памяти, требующийся для этого workflow (11.9+4.9+4+15.3+0.5+0.25) превышает 36.8 гигабайт! Для уменьшения аппетита искусственного интеллекта можно использовать квантованные версии, но все равно для нормальной работы потребуются значительные ресурсы и дорогостоящая видеокарта с объемом VRAM хотя бы 24 гигабайта.
На компьютере с 56 GB RAM и видеокартой Nvidia Tesla V100 16GB в описанном выше воркфлоу генерация одной картинки в разрешении 2862×2176 точек занимала более трех минут. Для решения вопроса с вопиющим медленнодействием сначала предпринималась безуспешная попытка использовать расширение ComfyUI-Distributed. После потери нескольких часов времени на попытки запустить совместную работу воркфлоу на двух компьютерах, был осуществлен переход на расширение ComfyUI-RemoteCLIPLoader.
С помощью этой программы к воркфлоу по 10GB-каналу (сетевая карта ConnectX-3 MCX311A на воркере) был подключен дополнительный компьютер с двумя видеокартами-ветеранами (Nvidia GeForce GTX1070 8GB + GTX1080 8GB). За счет этого удалось задействовать более точную языковую модель qwen3-vl-4b-heretic_f16.safetensors (8.3GB) вместо qwen3vl_4b_fp8_scaled, а также перенести туда узел vae. Благодаря этому скорость генерации выросла примерно на 20-30% (за счет сокращения операций по перекачке весов модели между SSD, оперативной памятью и видеокартой), сократившись примерно на 30-40 секунд (до 140-160 секунд). В этой статье излагается практическая последовательность действий по выносу текствого энкодера для обеспечения совместной работы двух компьютеров в бэкенде comfyui.
Для еще большего увеличения скорости работы в процесс можно добавить еще один компьютер для переноса на него весов диффузионной модели. Этот способ увеличения быстродействия workflow описывается в отдельной статье (подключение по сети еще двух видеокарт Nvidia GeForce GTX 1070 по 8GB). Несмотря на солидный возраст, видеокарты Nvidia 1000-1600-х серий (Pascal и Turing без тензоров) отлично работают с кодированием int8_convrot. Благодаря этому, VRAM главного компьютера можно разгрузить еще на примерно 12GB, используя чекпойнт Kreamania_v8 (11.9GB), перенесенный на вторую ноду. Таким образом, на основном компьютере с Nvidia Tesla V100 16GB остаются только LLM-улучшайзер промта (Qwen3-VL-2B-Instruct, 4GB) и SeedVR2 (seedvr2_ema_7b_fp16, 15.3GB плюс ema_vae_fp16, 478MB), которые почти полно
Настройка comfyui для работы с узлом, подключенным по локальной сети
По мнению автора, для выжимания всех соков из компьютерного железа бескомпромиссным решением является использование linux, желательно такого дистрибутива, который может из коробки использовать разные программные окружения, версии python, компиляторов и прочих «прибамбасов», иначе говоря — gentoo. Ставим на удаленную ноду эту прекрасную операционную систему с минимальным количеством мусора (в headless-варианте) и подключаемся к ней по ssh:
Ставим ComfyUI:
Сначала скачиваем исходники:
git clone https://github.com/Comfy-Org/ComfyUI.git && cd ComfyUI
python -m venv venv # venv-окружение создаем один раз, в последуюущем сразу переходим в нужный каатлог и актививруем там его командой source ./venv/bin/activate
source ./venv/bin/activate
pip install --upgrade pip
Для дальнейшего установки, учитывая использование видеокарт Nvidia Pascal, редактируем файл requirements.txt, внеся в него следующий список программ и зависимостей (по состоянию на начало сентября 2026 года):
--extra-index-url https://download.pytorch.org/whl/cu126

comfyui-frontend-package==1.51.9

comfyui-workflow-templates==0.11.54

comfyui-embedded-docs==0.5.10

torch==2.14.0+cu126

torchsde

torchvision==0.29.0+cu126

torchaudio

numpy>=2.4.0,<2.5.0

einops

transformers>=4.50.3

tokenizers>=0.13.3

sentencepiece

safetensors>=0.4.2

aiohttp>=3.11.8

yarl>=1.18.0

pyyaml

Pillow

scipy

tqdm

psutil

alembic

SQLAlchemy>=2.0.0

filelock

av>=17.0.0

comfy-kitchen==0.2.31

comfy-aimdo>=0.5.3

requests

simpleeval>=1.0.0

blake3

#non essential dependencies:

kornia>=0.7.1

spandrel

pydantic~=2.0

pydantic-settings~=2.0

PyOpenGL>=3.1.8

comfy-angle

xformers>=0.0.30; sys_platform == "linux"

onnxruntime-gpu==1.29.0

nvidia-nccl-cu12==2.29.3; sys_platform == "linux"

nvidia-nvcomp-cu12==5.3.0.16

bitsandbytes==0.49.1
Устанавливаем pytorch и остальные утилиты:
pip install -r requirements.txt
Проверяем успешность установки:
python3 -c "import torch; import torchaudio; print('PyTorch:', torch.__version__); print('Audio:', torchaudio.__version__); print('CUDA доступна:', torch.cuda.is_available())"
Получаем вывод:
PyTorch: 2.14.0+cu126

Audio: 2.11.0+cu126

CUDA доступна: True
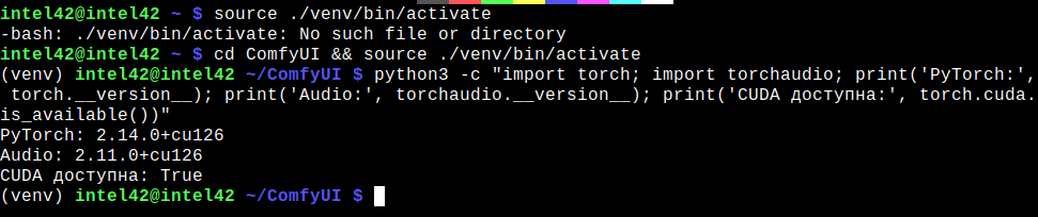
Несмотря на использование headless-системы, ставим comfyui-manager (к нему нужно будет подключаться через браузер с компьютера-мастера):
pip install -r manager_requirements.txt
Создаем скрипт запуска comfyui:
nano start_comfy.sh
Например, для Nvidia Tesla V100:
#!/bin/sh

export PYTORCH_CUDA_ALLOC_CONF="garbage_collection_threshold:0.6,max_split_size_mb:128,expandable_segments:True"

export CUDA_VISIBLE_DEVICES=0

export CUDA_MODULE_LOADING=LAZY

export COMFYUI_CRYSTOOLS_DEVICE="cuda"

export TORCH_COMPILE_DISABLE=1

# Отключение предупреждений и логов

export PYTHONWARNINGS="ignore"

export LOGURU_LEVEL="ERROR"

# Переопределение временной папки для pip

mkdir -p ~/pip_tmp

export TMPDIR=~/pip_tmp

=====================================================================

# 2. УПРАВЛЕНИЕ ПИТАНИЕМ И РАЗГОНОМ ВИДЕОКАРТ

=====================================================================

sudo nvidia-smi -pm 1

sudo nvidia-smi -i 0 -pl 210

sudo nvidia-smi -i 0 -ac 877,1530

=====================================================================

# 3. АКТИВАЦИЯ ВИРТУАЛЬНОГО ОКРУЖЕНИЯ

=====================================================================

if [ -f "./venv/bin/activate" ]; then

source ./venv/bin/activate

else

echo "Ошибка: виртуальное окружение ./venv не найдено!"

exit 1

fi

=====================================================================

# 4. ЗАПУСК COMFYUI С ОПТИМИЗИРОВАННЫМ КОНВЕЙЕРОМ VRAM

=====================================================================

PYTHONWARNINGS="ignore" python3 main.py \

--enable-manager \

--use-pytorch-cross-attention \

--force-fp16 \

--cuda-malloc \

--disable-metadata \

--fast-disk \

--async-offload 4 \

--enable-cors-header "*"
На подключаемой ноде при включении автоматически запускается RPC-сервер llama.cpp (эта тема частично рассматривалась в статье «Запуск llama.cpp в распределенном режиме по локальной сети»), для остановки службы llama-rpc при запуске comfyui и ее повторного автозапуска при остановке comfyui используем более продвинутый скрпит:
#!/bin/sh

# $HOME/start_comfy.sh

# --- 1. Автоматический апгрейд прав до sudo ---
# Если скрипт запущен от обычного пользователя, он сам запросит пароль один раз,
# выполнит системные настройки, но саму ComfyUI запустит безопасно — от вашего имени.
if [ "$(id -u)" -ne 0 ]; then
    echo "Перезапуск скрипта с правами sudo для настройки системы и видеокарт..."
    sudo "$0" "$@"
    exit $?
fi

# Запоминаем имя обычного пользователя, который вызвал скрипт
REAL_USER=${SUDO_USER:-$USER}
REAL_HOME=$(eval echo ~$REAL_USER)

# --- 2. Освобождение ресурсов (Остановка llama.cpp) ---
echo "=================================================="
echo "Шаг 1: Остановка службы llama-rpc через rc-service..."
echo "=================================================="
if rc-service llama-rpc status >/dev/null 2>&1; then
    rc-service llama-rpc stop
    echo "[OK] Служба llama-rpc успешно остановлена. Память очищена."
else
    echo "[Инфо] Служба llama-rpc уже была остановлена или не найдена."
fi

# Очистка памяти
sync
echo 3 > /proc/sys/vm/drop_caches
echo "[OK] Системный кэш оперативной памяти успешно очищен."
pkill -9 -f "python3 main.py" 2>/dev/null || true
echo "[OK] Все зависшие процессы Python успешно ликвидированы. VRAM очищена."


# --- 3. Настройка переменных окружения CUDA ---
export PYTORCH_CUDA_ALLOC_CONF="garbage_collection_threshold:0.6,max_split_size_mb:128,expandable_segments:True"
export CUDA_MODULE_LOADING=LAZY
export CUDA_VISIBLE_DEVICES=0,1

# --- 4. Настройка лимитов мощности и Persistence Mode ---
echo ""
echo "=================================================="
echo "Шаг 2: Включение Persistence Mode и лимитов мощности..."
echo "=================================================="
nvidia-smi -pm 1
nvidia-smi -i 0 -pl 120
nvidia-smi -i 1 -pl 120

# --- 5. Тюнинг частот (Разгон GPU 0 и памяти  ---
echo ""
echo "=================================================="
echo "Шаг 3: Применение оффсетов частот через NVML..."
echo "=================================================="
python3 -c '
import pynvml
try:
    pynvml.nvmlInit()
    h0 = pynvml.nvmlDeviceGetHandleByIndex(0)
    h1 = pynvml.nvmlDeviceGetHandleByIndex(1)

    # --- GPU 0: Разгон ядра (+95) и рабочей памяти (+600) ---
    pynvml.nvmlDeviceSetGpcClkVfOffset(h0, 95)
    pynvml.nvmlDeviceSetMemClkVfOffset(h0, 600)

    # --- GPU 1: Разгон ядра (+95) и рабочей памяти (+600) ---
    pynvml.nvmlDeviceSetGpcClkVfOffset(h1, 95)
    pynvml.nvmlDeviceSetMemClkVfOffset(h1, 600)

    # --- Управление вентиляторами на 30% для обеих карт ---
    for h in [h0, h1]:
        try:
            pynvml.nvmlDeviceSetFanControlPolicy(h, 0, 1) # 1 = ручной режим
            pynvml.nvmlDeviceSetFanSpeed_v2(h, 0, 30)     # Фиксация на 30%
        except Exception as fan_err:
            print(f"[Инфо]: Не удалось выставить вентилятор для карты: {fan_err}")

    pynvml.nvmlShutdown()
    print("[OK] Оффсеты разгона применены, вентиляторы зафиксированы на 30%!")
except Exception as e:
    print(f"[Ошибка NVML]: {e}")
'

# --- 6. Переход в рабочую директорию ComfyUI ---
# Скрипт пытается найти ComfyUI в домашней папке пользователя, либо берет текущую папку
CD_PATH="$REAL_HOME/ComfyUI"
if [ ! -d "$CD_PATH" ]; then
    CD_PATH="$(pwd)"
fi
cd "$CD_PATH" || exit 1

# --- 7. Запуск ComfyUI от имени обычного пользователя ---
echo ""
echo "=================================================="
echo "Шаг 4: Запуск ComfyUI от имени пользователя $REAL_USER..."
echo "=================================================="

  if [ -f "./venv/bin/activate" ]; then
      # Запускаем изолированную bash-сессию от обычного пользователя
      sudo -u "$REAL_USER" bash -c "
          # 1. Защита от Illegal Instruction (для старых CPU / kornia)
          export OPENBLAS_CORETYPE=NEHALEM
          export kornia_rs=0

          # 2. Настройка Multi-GPU видимости
          export CUDA_VISIBLE_DEVICES=0,1

          # 3. Оптимизация аллокатора PyTorch под две карты по 8GB VRAM
          export PYTORCH_CUDA_ALLOC_CONF='garbage_collection_threshold:0.8,max_split_size_mb:64,expandable_segments:True'
          export CUDA_MODULE_LOADING=LAZY

          source ./venv/bin/activate

          # 4. ЗАПУСК БЕЗ КРИТИЧЕСКИХ АРГУМЕНТОВ
          python3 main.py --listen 0.0.0.0 --port 8188 \
              --highvram \
              --fast \
              --use-split-cross-attention \
              --fp16-vae \
              --disable-metadata \
              --enable-cors-header '*' \
              --enable-manager
      "

else
    echo "Критическая ошибка: Виртуальное окружение ./venv не найдено в папке $(pwd)!"
    # В случае неудачи запуска всё равно пытаемся поднять текстовый сервер обратно
    rc-service llama-rpc start
    exit 1
fi

# --- 8. Восстановление системы после закрытия ComfyUI (Ctrl+C) ---
echo ""
echo "=================================================="
echo "Шаг 5: Восстановление работы фоновых сервисов..."
echo "=================================================="
echo "ComfyUI закрыт. Запуск службы llama-rpc обратно в работу..."
rc-service llama-rpc start
echo "[Готово] Система возвращена в исходное состояние."
Даем права выполнения скрипту запуска:
sudo chmod +x start_comfy.sh
и запускаем comfyui командой
./start_comfy.sh
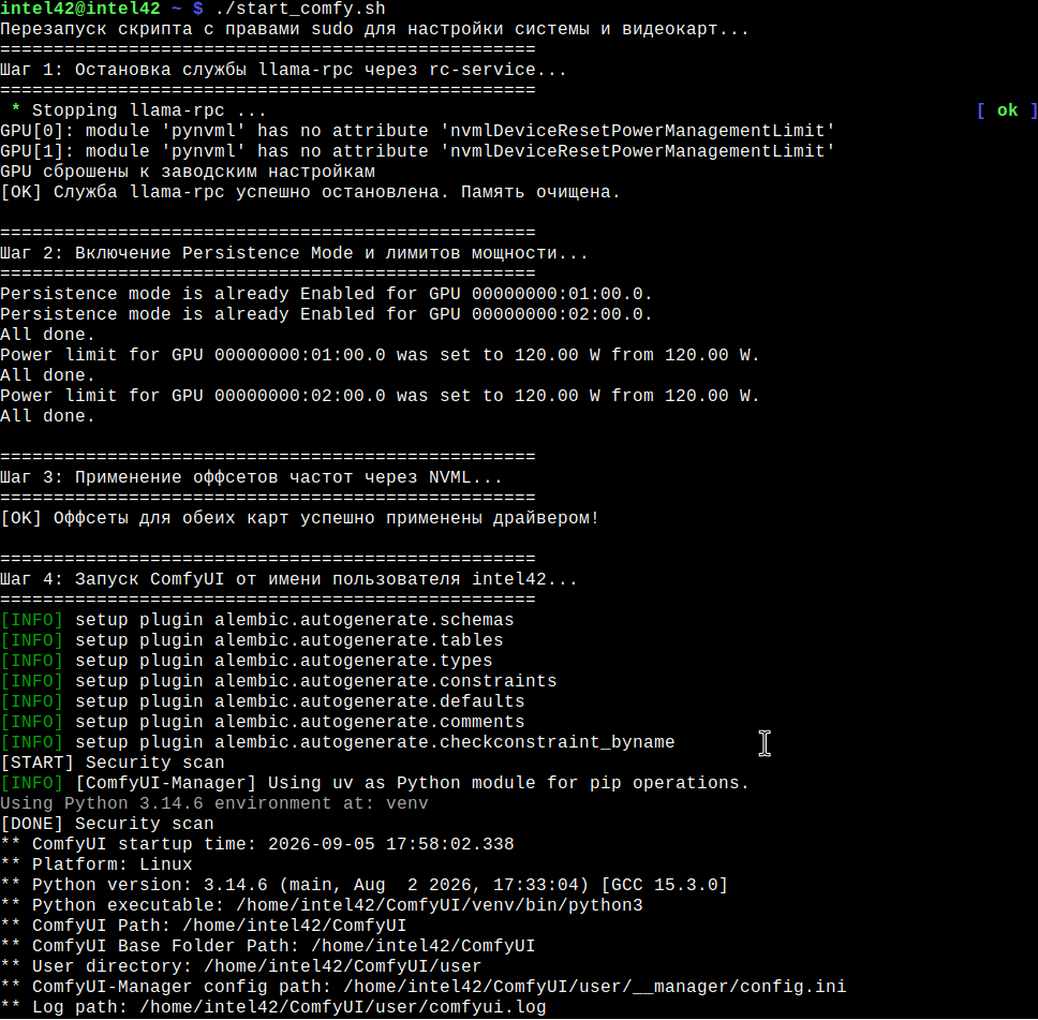
К удаленному comfyui теперь можно подключаться и работать дистанционно. Для этого в браузере управляющего компьютера нужно ввести локальный адрес ноды, например, http://192.168.3.42:8188.
Чтобы выгрузить на локальную ноду с несколькими видеокартами текстовый энкодер, в под папку custom_nodes в директории comfyui нужно установить узлы ComfyUI-MultiGPU и ComfyUI-RemoteCLIPLoader:
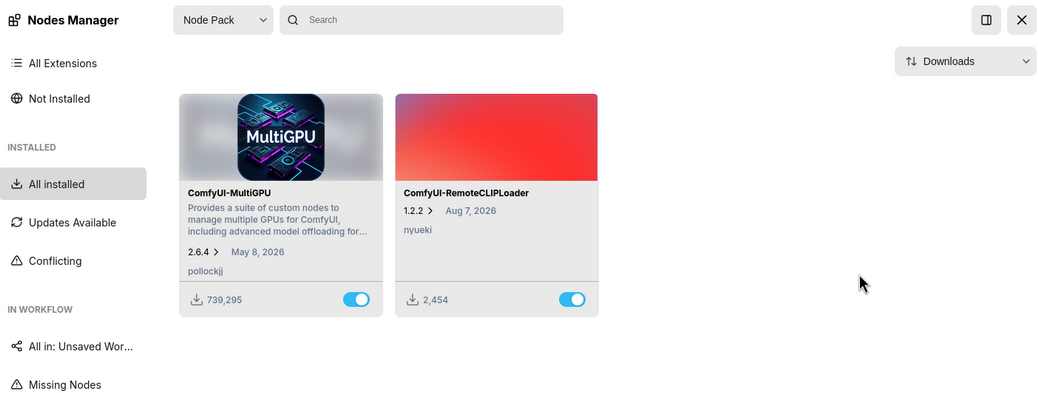
ComfyUI-RemoteCLIPLoader в данном случае будет работать по принципу: одна машина кодирует текст (Sender), а вторая генерирует картинку (Loader).
Если не получается установить эти расширения с помощью comfyui-manager (через браузер на компьютере-мастере), это можно сделать вручную, через консоль.
Для этого закрываем comfyui (нажимаем ctrl+c в терминале запуска), а потом клонируем исходники нужных расширений в папку custom_nodes:
cd $HOME/ComfyUI/custom_nodes/
git clone https://github.com/nyueki/ComfyUI-RemoteCLIPLoader.git
cd $HOME/ComfyUI/ && source ./venv/bin/activate
cd custom_nodes/ComfyUI-RemoteCLIPLoader/
pip install -r requirements.txt
Для multiGPU-системы нужно установить дополнительный узел:
cd $HOME/ComfyUI/custom_nodes/ && git clone https://github.com/pollockjj/ComfyUI-MultiGPU.git
cd $HOME/ComfyUI/ && source ./venv/bin/activate && cd custom_nodes/ComfyUI-RemoteCLIPLoader/
pip install -r requirements.txt
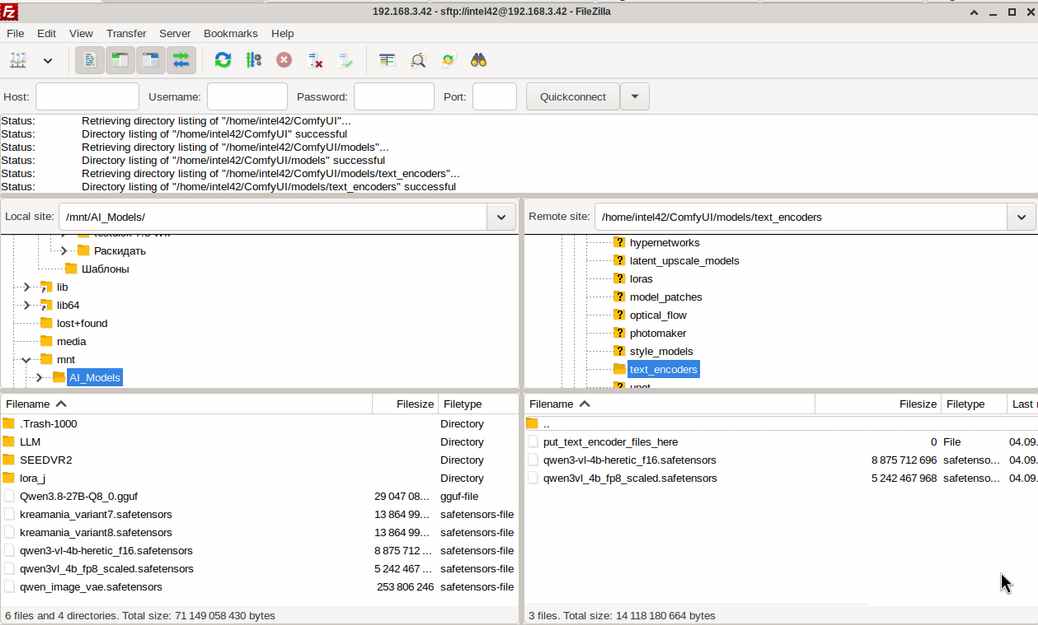
Закачиваем в каталог /ComfyUI/models/text_encoders свои модели (с основного компьютера это удобно делать в filezilla):
Выходим из виртуального окружения и запускаем comfyui:
deactivate && cd $HOME/
./start_comfy.sh
Теперь через браузер основного компа можно подключаться к comfyui локальной ноды. Там нужно создать узлы CLIPLoaderDisTorch2MultiGPU и Send Remote CLIP для выгрузки текстового энкодера на две видеокарты:
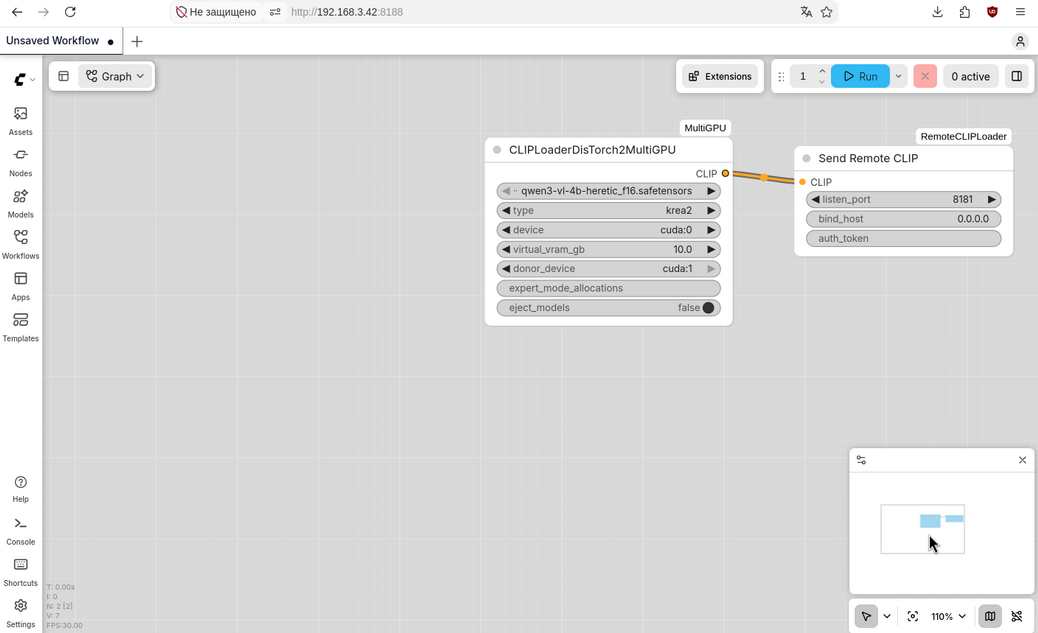
Для этого:
- Нажимаем правую кнопку мыши на пустом поле.
- Переходим по ветке: Add Node — Remote CLIP и создаем узел Send Remote CLIP:
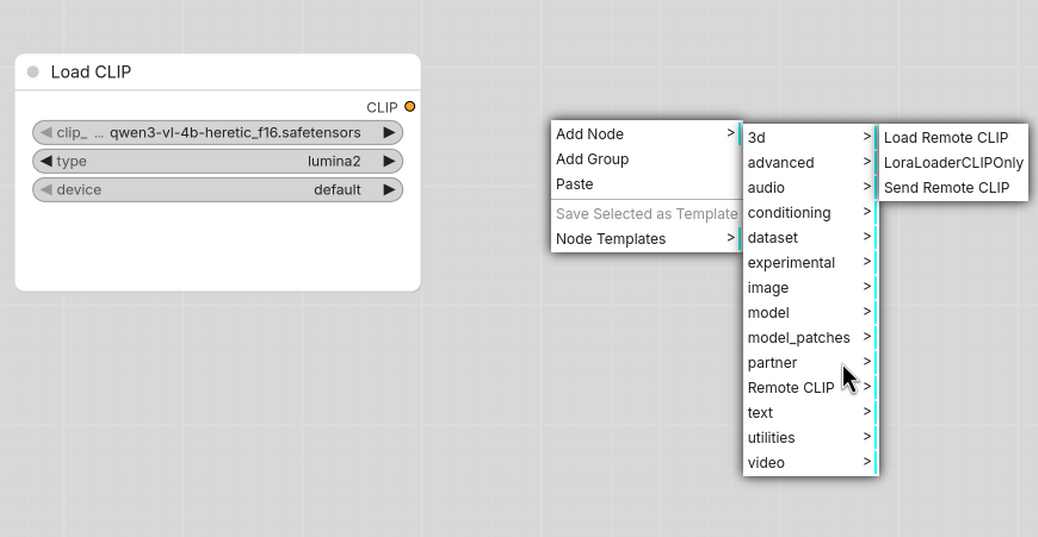
Выбираем нужный энкодер в узле Load CLIP, указываем там тип модели (krea2), а также указываем свой адрес и (необязательно) пароль (auth_token) в полях узла Send Remote CLIP:
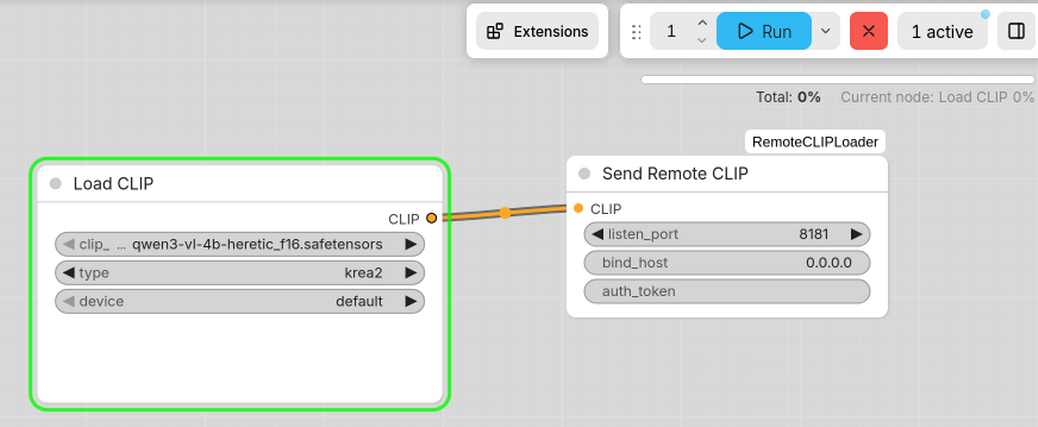
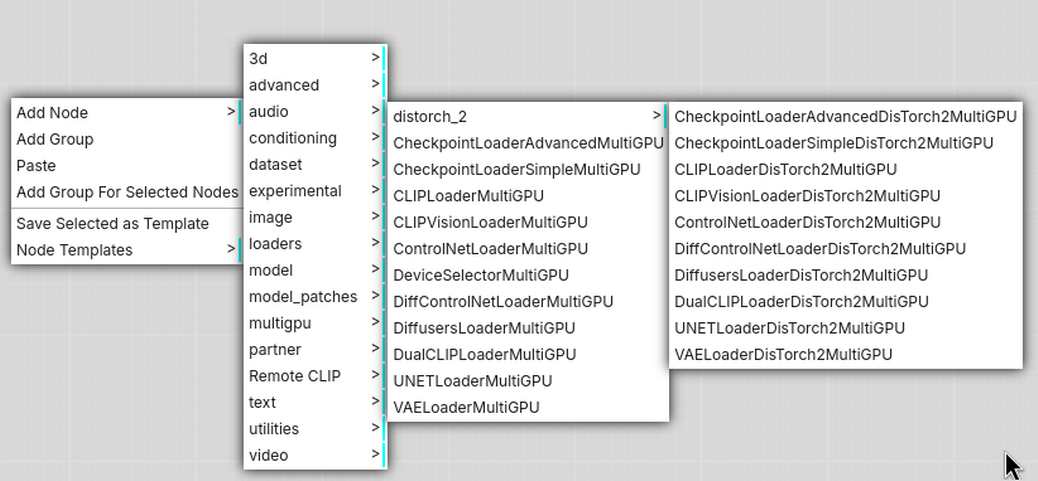
На компьютере с несколькими видеокартами в воркфлоу используем расширение ComfyUI-MultiGPU. Вместо CLIPLoader для текстового энкодера в такой конфигурации используется узел CLIPLoaderDisTorch2MultiGPU (или DualCLIPLoaderDisTorch2MultiGPU для Flux/SDXL).
Его можно найти по пути Add Node — Remote CLIP — distorch_2 — CLIPLoaderDisTorch2MultiGPU:
Выход CLIP этого узла подключается ко входу clip узла Send Remote CLIP:
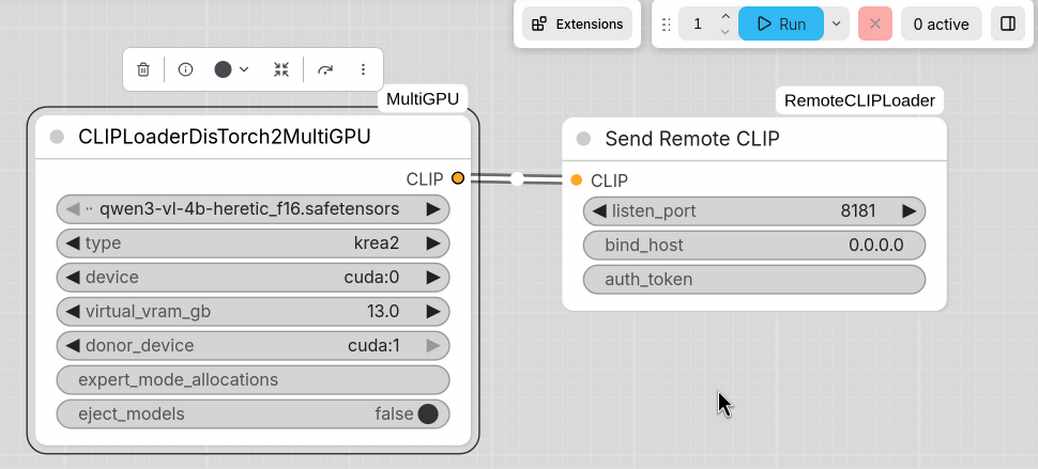
В полях настройки CLIPLoaderDisTorch2MultiGPU нужно выбрать свой энкодер, тип модели, распределить нагрузку весов по видеокартам (device и donor device), задать размер виртуальной памяти, доступной для нейросети. Чтобы comfyui мог нормально работать с двумя видеокартами в скрипте запуска обязательно нужно прописать export CUDA_VISIBLE_DEVICES=0,1.
После настройки удаленного воркфлоу можно нажимать старт (Queue Prompt), чтобы запустить сервер ноды comfyui.
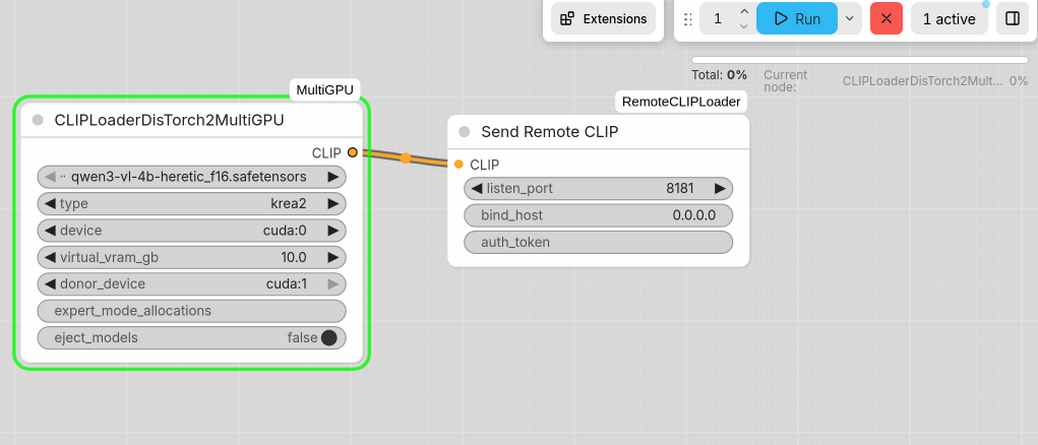
В терминале запуска comfyui можно проследить состояние подключенной ноды:
…[INFO] [MultiGPU Core Patching] Patching mm.soft_empty_cache for Comprehensive Memory Management (VRAM + CPU + Store Pruning)…
[MultiGPU DisTorch V2] Full allocation string: #cuda:0;10.0;cuda:1
[RemoteCLIP 18:44:47] WARNING: worker bound to 0.0.0.0 with no auth token. Anyone on the network can use this CLIP. Set auth_token or bind to a specific host.
[RemoteCLIP 18:44:47] Worker listening on 0.0.0.0:8181
Prompt executed in 96.52 seconds
Инициализация воркера заняла 96 секунд. Они ушли на первый запуск с конвертацией слоев большой FP16-модели qwen3-vl-4b-heretic_f16.safetensors (размер 8.3GB). Дополнительное время ушло на на инициализацию PCIe шины для прямого обмена данными между видеокартами. Благодаря переносу текстового энкодера на другой компьютер при каждом запросе от мастера воркер будет очень быстро (от долей до до нескольких секунд) кодировать текст и возвращать готовые эмбеддинги, тем самым значительно сокращая общее время генерации.
После перевода ноды с текстовым энкодером в режим ожидания, настраиваем Main Server, где работает основной воркфлоу, устанавливаем ComfyUI-RemoteCLIPLoader в custom_nodes. Затем запускаем ComfyUI в обычном режиме.
Открываем веб-интерфейс, вместо штатного CLIP Loader добавляем на холст ноду Load Remote Clip, указываем в ней адрес локальной ноды и auth_token:
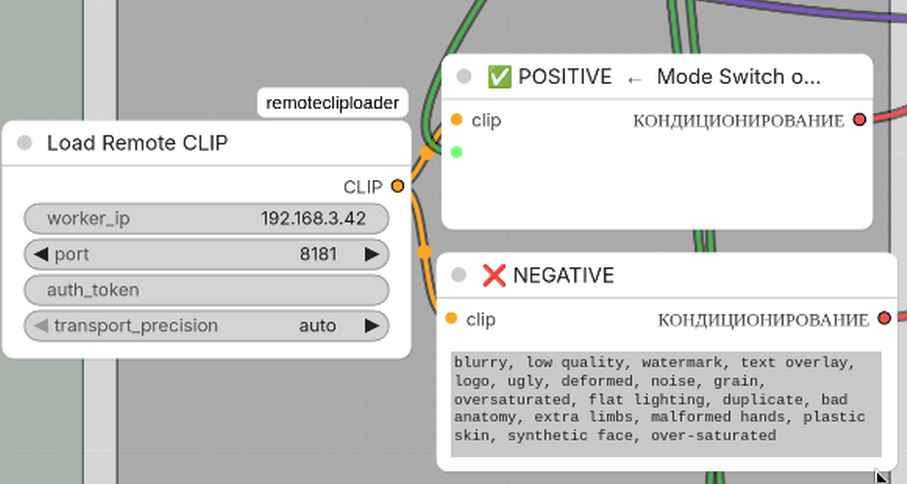
После этого, после запуска генерации на компе-мастере текстовый промпт отправляется на воркер, где во время кодирования задействуются обе карты, после чего готовые текстовые тензоры возвращаются на мастер для генерации картинки.
Лог работы удаленной ноды в процессе генерации:
…FETCH DATA from: /home/intel42/ComfyUI/venv/lib/python3.14/site-packages/comfyui_manager/custom-node-list.json [DONE]
…[INFO] Requested to load Krea2TEModel_
[INFO] Model Krea2TEModel_ prepared for dynamic VRAM loading. 8463MB Staged. 0 patches attached. Force pre-loaded 249 weights: 627 KB.
In file included from /usr/include/python3.14/Python.h:14, from /home/intel42/ComfyUI/venv/lib/python3.14/site-packages/triton/backends/nvidia/driver.c:9: /usr/include/python3.14/pyconfig.h:2007:9: warning: ‘_POSIX_C_SOURCE’ redefined 2007 | #define _POSIX_C_SOURCE 200809L
In file included from /usr/include/bits/libc-header-start.h:33, from /usr/include/stdlib.h:26, from /home/intel42/ComfyUI/venv/lib/python3.14/site-packages/triton/backends/nvidia/include/cuda.h:56, from /home/intel42/ComfyUI/venv/lib/python3.14/site-packages/triton/backends/nvidia/driver.c:1: /usr/include/features.h:319:10: note: this is the location of the previous definition 319 | # define _POSIX_C_SOURCE 202405L
[RemoteCLIP 21:27:13] Sent embeddings (3317760 bytes)
[INFO] 0 models unloaded.[INFO] Model Krea2TEModel_ prepared for dynamic VRAM loading. 8463MB Staged. 0 patches attached. Force pre-loaded 249 weights: 627 KB.[RemoteCLIP 21:27:13] Sent embeddings (9891840 bytes)
По логу видно, что RemoteCLIP успешно открыл порт 8181 и принял входящее подключение с основного компьютера (IP 192.168.3.35), далее он увидел запрос от мастера, успешно нашел и подготовил к работе модель Krea2TEModel_ объемом 8463 МБ (8.4 ГБ). При генерации был произведен успешный обмен текстовым промптом, произведено его превращение в векторы.
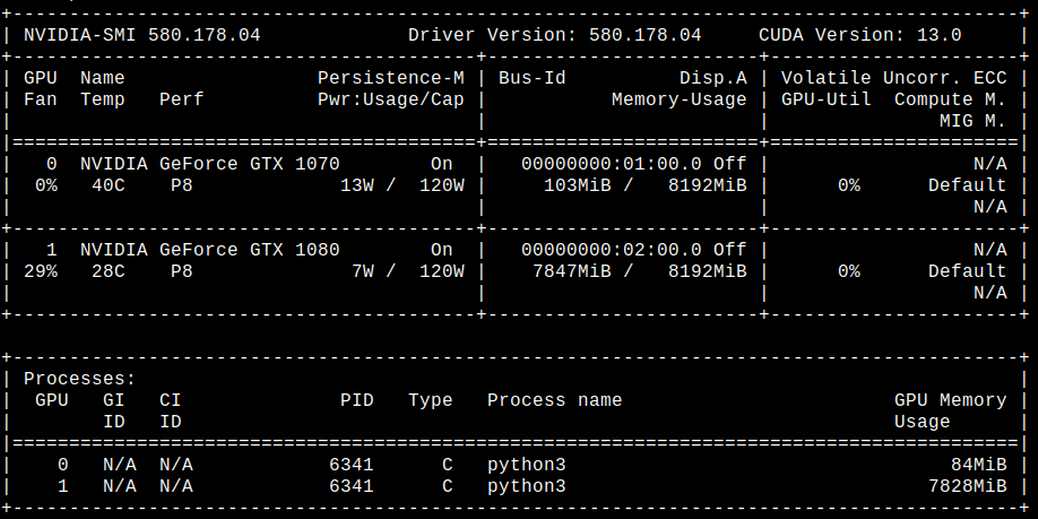
Скриншоты nvtop и консолей comfyui мастера и ноды во время совместной работы:
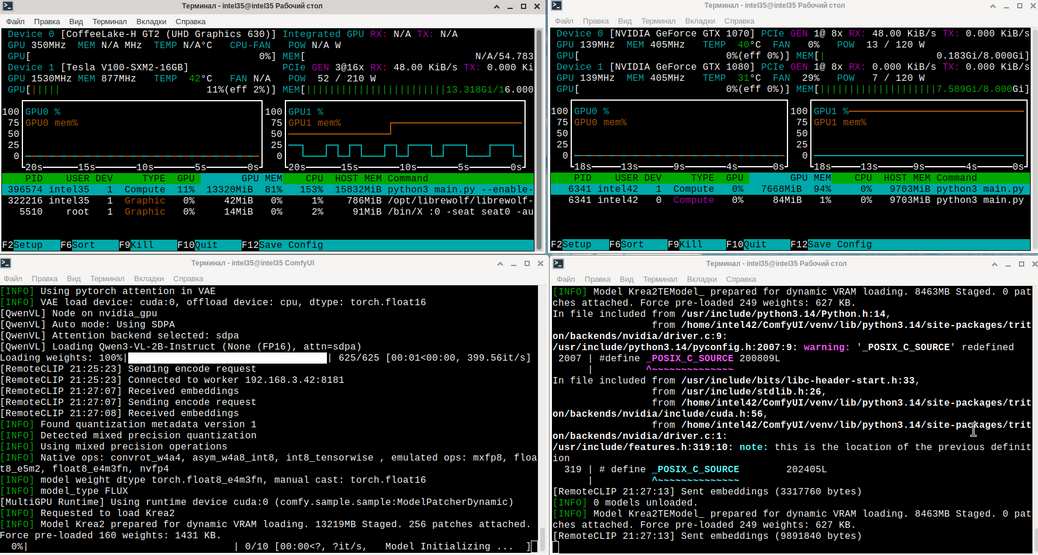
Загрузка памяти видоекарт при работе удаленной ноды в качестве выносного текстового энкодера:
Заключение
Перенос текстового энкодера на отдельный узел — минимально инвазивный способ снять VRAM-нагрузку с основной видеокарты, не трогая при этом сам воркфлоу генерации изображения. Связка ComfyUI-RemoteCLIPLoader и ComfyUI-MultiGPU дает не только прирост скорости на 20-30% за счёт сокращения перекачки весов между SSD, RAM и VRAM, но и позволяет задействовать более точную, не квантованную языковую модель для промпт-энкодинга — то, на что раньше просто не хватало памяти на мастере. Разовая цена — около полутора минут на первичную инициализацию воркера при холодном старте, что совершенно не критично для рабочего процесса.
Важно понимать границы метода: RemoteCLIP не объединяет вычислительную мощность карт для одной и той же операции — он лишь переносит расчёт целого узла (кодирование текста) на другую машину целиком. Именно поэтому связка Pascal-карт без тензорных ядер здесь отлично справляется: кодирование текста не требует flash-attention или FP8-тензорных операций, аппаратной поддержки которых у GTX 1070/1080 попросту нет.
На этом ресурсы двухкарточного ветерана-воркера не исчерпаны: в следующей статье мы подключим ещё один узел с парой GTX 1070, чтобы разгрузить и саму диффузионную модель, оставив на Tesla V100 только промпт-улучшайзер и апскейлер SeedVR2 — это должно кардинально изменить картину по скорости всего пайплайна.


Вам также может понравиться
Отключение USB‑контроллеров и аудио-устройств видеокарт для освобождения ресурсов шины PCI-E в Linux

DIY настольный фрезерный станок с ЧПУ — подготовительный этап