Сборка пакетов comfyui, адаптированных под свое железо в linux
Каждая новая версия PyTorch обычно приносит новые возможности и опции, облегчающие работу с AI-приложениями. В то же время, официальные бинарные сборки компилируются под обобщенные GPU и CPU. Более того, для старых видеокарт поддержка со временем и вовсе вырезается из готовых пакетов.
Самостоятельная сборка из исходных кодов позволяет решить эти проблемы: задействовать наиболее подходящее системное окружение CUDA, а также использовать флаг march=native, выжимающий максимум производительности из процессора. На выходе получатся компактные, максимально быстро работающие программы, собранные исключительно под свое железо. Самостоятельная сборка пакетов comfyui для старых видеокарт позволяет задействовать связку CUDA12.9 + pytorch 2.14, в то время как готовые бинарники распространяются только в вариантах CUDA12.6+pytorch 2.14, либо CUDA 12.9+pytorch 2.10. В первом случае (старая CUDA и новый torch) теряются преимущества более новой версии CUDA, подходящей для видеокарт Nvidia Tesla, Pascal и Maxwell, проблематично собрать неофициальное расширение FlashAttention Tesla V100. Во втором случае (новая CUDA и старый torch) пропадают всевозможные оптимизации, появившиеся в последних версиях pytorch.
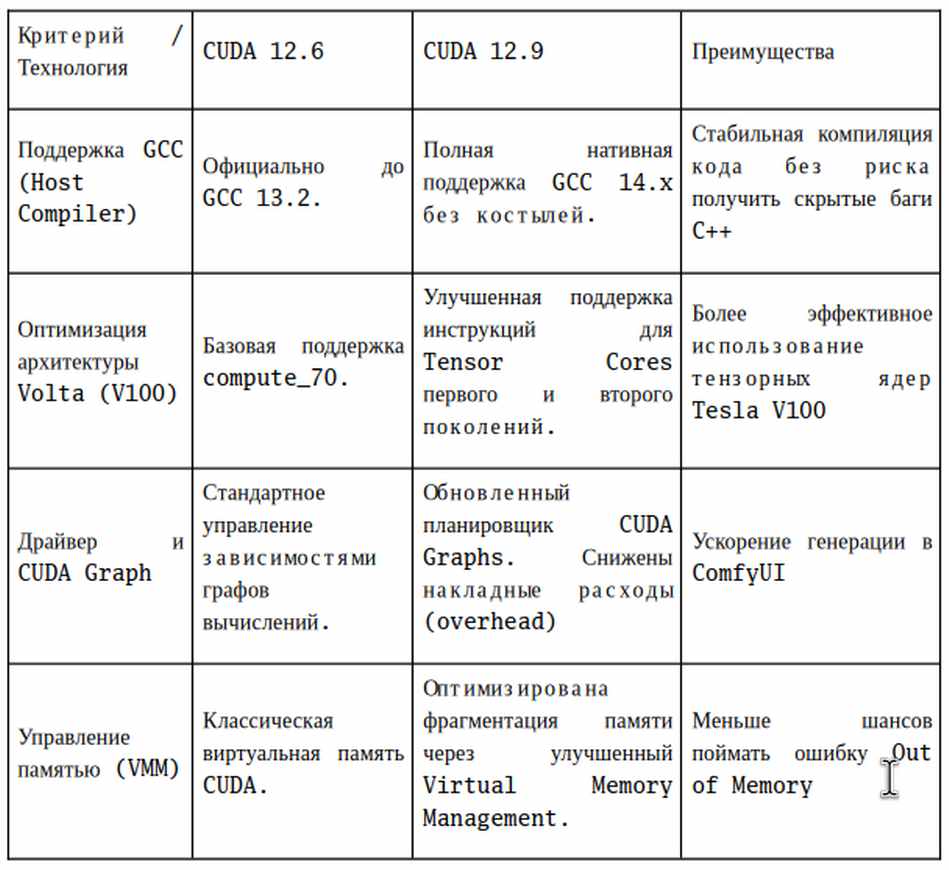
Сравнение CUDA 12.6 vs CUDA 12.9:
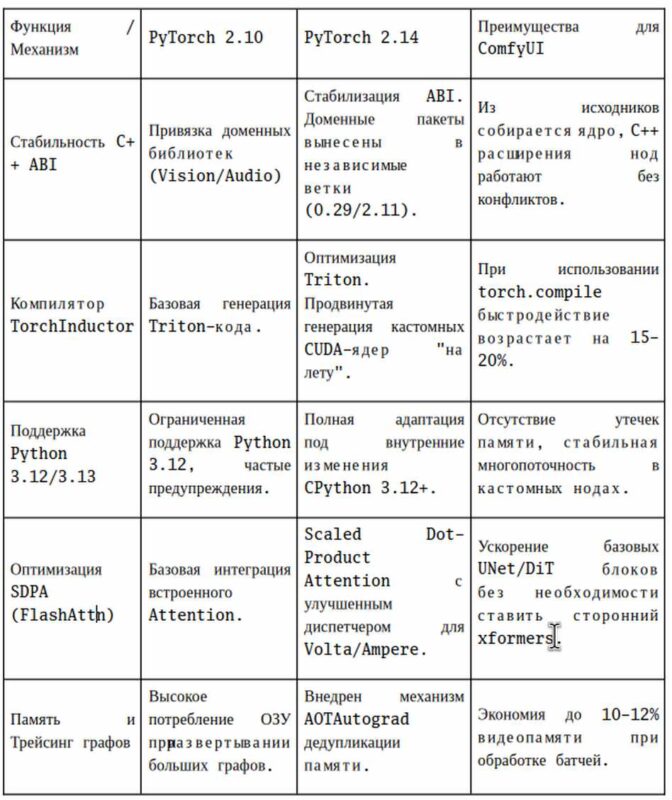
Сравнение PyTorch 2.10 vs PyTorch 2.14:
Как видно из таблиц выше, CUDA 12.9 позволяет использовать более новый компилятор GCC-14, а PyTorch 2.14 приносит кардинальные улучшения в работе с памятью и встроенными механизмами Attention (SDPA). В сочетании с флагом -march=native, который перестраивает весь C++ код под инструкции процессора, сводятся до минимума «бутылочные горлышки» между CPU и GPU во время генерации. Таким образом, «овчинка стоит выделки» — есть смысл приложить усилия и собрать бэкенд ComfyUI, адаптированный под свое оборудование. Это в особенности актуально для gentoo linux, которая как раз и «заточена» на работу с собираемыми из исходного кода программами.
Далее рассматривается последовательность действий по сборке из исходников pytorch 2.14.0, torchvision 0.29.0, torchaudio 2.11.0, а также некоторых пакетов из состава ComfyUI:
- safetensors — отвечает за чтение весов моделей (checkpoint-файлы) с диска в память. Написана на Rust, сборка из исходников с флагами оптимизации (-O3 -march=native) через cargo позволяет использовать векторные инструкции CPU для максимально быстрой десериализации тензоров и прямой загрузки в VRAM (Zero-copy). Скорость загрузки моделей (особенно больших вроде SDXL или Flux) станет упираться только в скорость вашего HDD/NVMe/SSD;
- tokenizers — требуется для разбиения текста на токены (используется в CLIP, T5 и текстовых энкодерах). Написана на Rust, кастомная сборка ускоряет этап парсинга промптов (особенно длинных или при пакетной генерации) на CPU;
- av (PyAV) — библиотека для работы с видео (декодирование/кодирование кадров). Если собрать ее из исходников, связав с системным пакетом media-video/ffmpeg, обработка видео-инпутов становится значительно быстрее;
- scipy/Pillow — библиотеки обработки матриц и картинок на CPU. Сборка scipy с использованием Intel MKL или OpenBLAS ускорит математические ноды. Pillow, собранная с -march=native быстрее ресайзит и сохраняет картинки.
- Kornia — библиотека компьютерного зрения на базе PyTorch, при нативной сборке может дать небольшой плюс к скорости фильтрации и геометрии изображений.
Python-модули, обертки и утилиты, сетевые и сервисные пакеты ComfyUI вручную собирать не стоит, так как прироста производительности при работе с нейросетевыми моделями это практически не дает.
При создании максимально оптимизированного окружения в Gentoo сборку желательно производить в три этапа:
- сборка torch с оптимизацией под конкретную архитектуру GPU и инструкции CPU;
- сборка torchvision, torchaudio с опорой на уже скомпилированный torch;
- сборка библиотек прикладного окружения (safetensors, tokenizers, scipy, Pillow, Kornia и т.д.).
Сборка кастомных версий Pytorch, TorchVision, TorchAudio:
Переходим в каталог, куда будет производиться установка кастомизированного окружения ComfyUI и создаем там виртуальное окружение:
git clone https://github.com/Comfy-Org/ComfyUI.git comfui && cd comfui
python3.12 -m venv venv && source ./venv/bin/activate
pip install --upgrade pip setuptools wheel ninja psutil scikit-build-core pyproject-metadata pathspec typing_extensions PyYAML jinja2 six numpy mkl mkl-include pillow filelock mpmath sympy networkx
В дальнейшем, перед работой с comfyui, в том числе для сборки кастомных версий библиотек, предварительно активируем виртуальное окружение командой:
source ./venv/bin/activate
Каждая версия torchvision и torchaudio привязана к конкретному релизу torch. Поэтому при сборке из исходников нужно скачивать их совместимые релизы (сверяться с файлами RELEASE.md и setup.py в репозитории PyTorch). На момент написания статьи новейшие версии этих файлов: torch 2.14.0, torchvision 0.29.0, torchaudio 2.11.0.
Собираем из исходников torch с поддержкой системных библиотек NCCL:
git clone --recursive --branch v2.14.0 https://github.com/pytorch/pytorch && cd pytorch
export TORCH_CUDA_ARCH_LIST="7.0"

export CUDAFLAGS="-O3 --allow-unsupported-compiler -ccbin /usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc -Wno-deprecated-gpu-targets"

export CFLAGS="-O3 -march=native -pipe -fno-semantic-interposition -Wno-error -Wno-template-id-cdtor -Wno-mismatched-new-delete -Wno-stringop-overread -Wno-stringop-overflow"

export CXXFLAGS="-O3 -march=native -pipe -fno-semantic-interposition -Wno-error -Wno-template-id-cdtor -Wno-mismatched-new-delete -Wno-stringop-overread -Wno-stringop-overflow"

export USE_SYSTEM_NCCL=1

export NCCL_ROOT="/usr/local"

export NCCL_INCLUDE_DIR="/usr/local/include"

export NCCL_LIB_DIR="/usr/local/lib"

export FORCE_CUDA=1

export USE_CUDA=1

export CMAKE_GENERATOR=Ninja

export REL_WITH_DEB_INFO=0

export CMAKE_PREFIX_PATH="${VIRTUAL_ENV}:${CMAKE_PREFIX_PATH}"

export CC="/usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc"

export CXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"


export CUDAHOSTCXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"


export CMAKE_ARGS="-DCMAKE_CUDA_STANDARD=20 -DCMAKE_CXX_FLAGS='-Wno-error' -DCMAKE_C_FLAGS='-Wno-error'"
Чтобы сохранить резервную копию кастомного установочного файла torch в папку ~/backup_torch/ сборку производим командой:
pip wheel . --no-build-isolation --no-deps -w ~/backup_torch/ && cd .. && rm -rf pytorch
Устанавливаем torch, собранный из исходников, командой
pip install ../dist/torch-*.whl --no-deps
Каталог с файлами собранного из исходного кода torch 2.14+cu12.9 с поддержкой Nvidia Tesla V100 занимает меньше 1GB, в то время как каталог с бинарной версией torch 2.14+cu12.6 — более 2 GB.
Сборка torchvision:
export CC="/usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc"

export CXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"

export CUDAHOSTCXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"

export TORCH_CUDA_ARCH_LIST="7.0"

export CUDAFLAGS="-O3 --allow-unsupported-compiler -ccbin /usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc -Wno-deprecated-gpu-targets"

export CFLAGS="-O3 -march=native -pipe -fno-semantic-interposition -Wno-error -Wno-template-id-cdtor -Wno-mismatched-new-delete -Wno-stringop-overread -Wno-stringop-overflow"

export CXXFLAGS="-O3 -march=native -pipe -fno-semantic-interposition -Wno-error -Wno-template-id-cdtor -Wno-mismatched-new-delete -Wno-stringop-overread -Wno-stringop-overflow"

export FORCE_CUDA=1

export USE_CUDA=1

export CMAKE_GENERATOR=Ninja

export REL_WITH_DEB_INFO=0

export CMAKE_PREFIX_PATH="${VIRTUAL_ENV}:${CMAKE_PREFIX_PATH}"

export CMAKE_ARGS="-DCMAKE_CUDA_STANDARD=20 -DCMAKE_CXX_FLAGS='-Wno-error' -DCMAKE_C_FLAGS='-Wno-error'"

git clone --recursive --branch v0.29.0 https://github.com/pytorch/vision && cd vision

pip wheel . --no-build-isolation --no-deps -w ~/backup_torch/ && cd .. && rm -rf vision

pip install ~/backup_torch/torchvision-*.whl --no-deps
Сборка torchaudio с теми же флагами:
git clone --recursive --branch v2.11.0 https://github.com/pytorch/audio && cd audio

pip wheel . --no-build-isolation --no-deps -w ~/backup_torch/ && cd .. && rm -rf audio

pip install ~/backup_torch/torchaudio-*.whl --no-deps
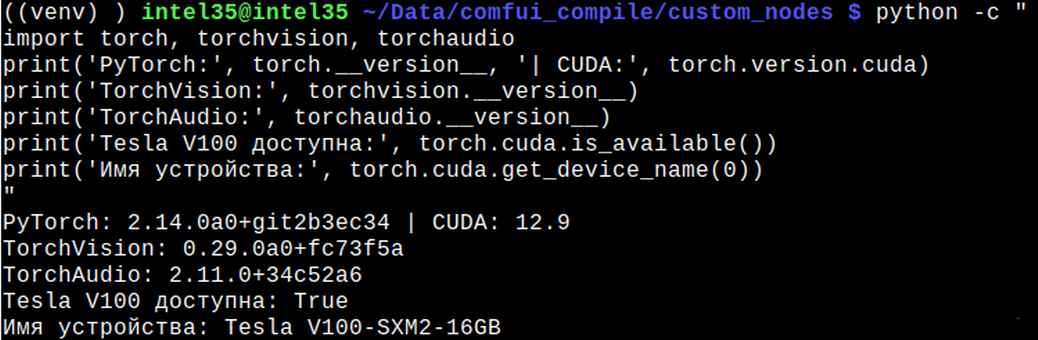
Проверка успешности установки:
python -c "

import torch, torchvision, torchaudio

print('PyTorch:', torch.__version__, '| CUDA:', torch.version.cuda)

print('TorchVision:', torchvision.__version__)

print('TorchAudio:', torchaudio.__version__)

print('Tesla V100 доступна:', torch.cuda.is_available())

print('Имя устройства:', torch.cuda.get_device_name(0))

"
Резервирование и восстановление кастомных версий torch, torchvision и torchaudio
Обычно сборка и установка кастомных файлов в виртуальном окружении comfyui производится командой
pip install --no-build-isolation --no-deps -v .
Чтобы не потерять результаты сборки (например, при случайном обновлении через pip), собранный PyTorch нужно упаковать в готовый wheel-пакет (.whl). Этот способ сборки как раз и описан выше. Плюс такого бэкапа в том, что его можно быстро установить в любое другое виртуальное окружение на этой машине командой pip install имя_файла.whl, при этом — больше не потребуется долгая компиляция.
На этапе сборки можно создать бэкап-пакет командой:
pip wheel . --no-build-isolation --no-deps -w ~/backup_torch/
При этом Ninja полностью скомпилирует PyTorch, но не будет устанавливать его в текущий venv, а упакует в один готовый файл и положит его в созданную папку dist (каталогом выше).
Название файла будет иметь следующий формат:
torch-2.14.0a0+git...-cp312-cp312-linux_x86_64.whl.
После этого его можно установить в систему командой:
pip install ../dist/torch-*.whl --no-deps
Для torchvision и torchaudio сохраняем резервыне копии аналогичным образом.
Порядок восстановления файлов из бэкапов:
source ./venv/bin/activate
# 1. Сначала возвращаем ядро
pip install ~/backup_torch/torch-*.whl --no-deps
# 2. Затем восстанавливаем спутники (torchvision и torchaudio)
pip install ~/backup_torch/torchvision-*.whl --no-deps
pip install ~/backup_torch/torchaudio-*.whl --no-deps
Прикладные пакеты резервировать смысла не имеет, так как они быстро пересобираются в случае необходимости.
Сборка кастомных модулей ComfyUI
Для сборки кастомных модулей под видеокарту Nvidia Tesla V100 (архитектура Volta, sm_70) и свой CPU задаем соответствующие флаги компиляторов, а также форсируем оптимизацию для Rust-модулей:
# Разрешаем совместимость ABI для Rust-модулей

export PYO3_USE_ABI3_FORWARD_COMPATIBILITY=1

# Оптимизация для Rust (safetensors, tokenizers) под CPU

export RUSTFLAGS="-C target-cpu=native -C opt-level=3 -C link-arg=-fuse-ld=mold"

# Флаги для NVCC (CUDA-компилятора)

export CUDAFLAGS="-O3 --allow-unsupported-compiler -ccbin /usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc -Wno-deprecated-gpu-targets"

export TORCH_CUDA_ARCH_LIST="7.0"

# Флаги CPU оптимизации для GCC 14 в Gentoo

export CFLAGS="-O3 -march=native -pipe -fno-semantic-interposition -Wno-error -Wno-template-id-cdtor -Wno-mismatched-new-delete -Wno-stringop-overread -Wno-stringop-overflow"

export CXXFLAGS="-O3 -march=native -pipe -fno-semantic-interposition -Wno-error -Wno-template-id-cdtor -Wno-mismatched-new-delete -Wno-stringop-overread -Wno-stringop-overflow"

# Запускаем компиляцию пакетов из исходных кодов

pip install safetensors av scipy Pillow kornia --no-binary safetensors,av,scipy,Pillow,kornia --no-cache-dir
Из-за багов оптимизатора в экспериментальных сборках компилятора (например, rustc 1.99.0-nightly), сборка Rust-пакета tokenizers аварийно завершается с ошибкой кодогенератора (Internal Compiler Error). Для успешной компиляции требуется переключить тулчейн на стабильную версию Rust.
Устанавливаем стабильный системный компилятор:
sudo emerge --ask =dev-lang/rust-1.98.1
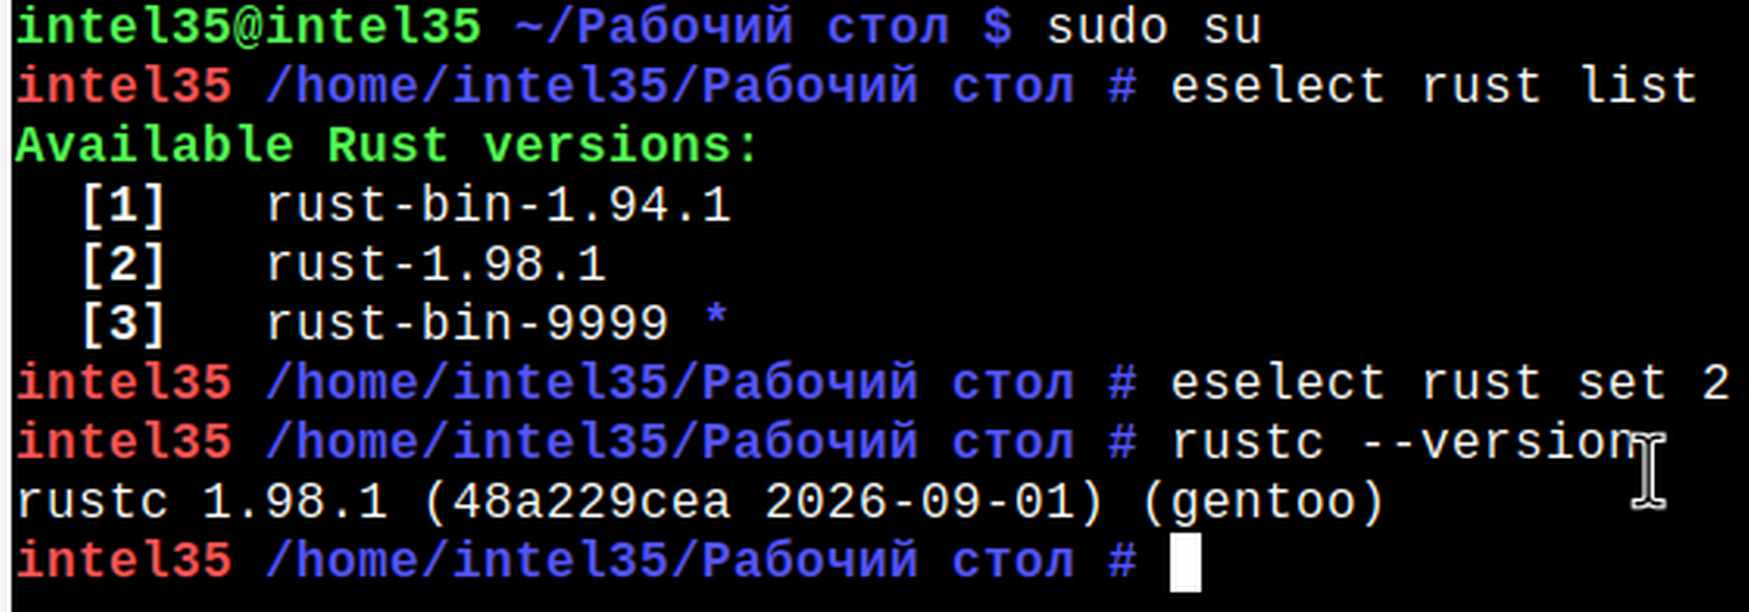
Затем переключаем активный компилятор в среде с помощью утилиты eselect (выберите номер, соответствующий стабильной версии):
# Смотрим список доступных компиляторов Rust

eselect rust list

# Устанавливаем стабильную версию по умолчанию (например, вторую в списке)

eselect rust set 2

# Проверяем, что тулчейн обновился

rustc --version
Снова переходим в виртуальное окружение и собираем tokenizers (команды для системы с установленным mold):
source ./venv/bin/activate
export RUSTFLAGS="-C target-cpu=native -C opt-level=3 -C link-arg=-fuse-ld=mold"
pip install tokenizers --no-binary tokenizers --no-cache-dir
Затем ставим остальные зависимости согласно списку в файле requirements.txt из каталога ComfyUI. Предварительно из него нужно исключить (закомментировать), те пакеты, которые собирались самостоятельно.
Пример содержимого отредактированного файла requirements.txt каталога ComfyUI по состоянию на 21.09.2026:
# custom-файл ComfyUI/requirements.txt


comfyui-frontend-package==1.53.6


comfyui-workflow-templates==0.11.66


comfyui-embedded-docs==0.5.12


torchsde


numpy>=1.25.0


einops


transformers>=4.50.3


sentencepiece


aiohttp>=3.11.8


yarl>=1.18.0


pyyaml


tqdm


psutil


alembic


SQLAlchemy>=2.0.0


filelock


comfy-kitchen==0.2.35


comfy-aimdo==0.5.5


requests


simpleeval>=1.0.0


blake3


#non essential dependencies:


spandrel

pydantic~=2.0


pydantic-settings~=2.0


PyOpenGL>=3.1.8


comfy-angle
Ставим эти библиотеки стандартным способом:
pip install -r requirements.txt
Затем ставим comfyui-manager:
git clone https://github.com/comfy-org/ComfyUI-Manager custom_nodes/ComfyUI-Manager
Редактируем файл requirements.txt в каталоге custom_nodes/ComfyUI-Manager/, удаляя из него ранее собранные кастомные библиотеки (transformers).
cd custom_nodes/ComfyUI-Manager && pip install -r requirements.txt
Устанавливаем bitsandbytes:
source ./venv/bin/activate
cd $HOME/Data/comfui/custom_nodes/
git clone https://github.com/bitsandbytes-foundation/bitsandbytes && cd bitsandbytes
export CUDA_HOME="/opt/cuda"

export CUDA_VERSION="129"

export BNB_CUDA_ARCHs="70"

pip install --no-build-isolation --no-deps -v .

cd .. && rm -rf bitsandbytes
Устанавливаем LLM-движок llama-cpp-python:
git clone --recursive https://github.com/abetlen/llama-cpp-python && cd llama-cpp-python
CMAKE_ARGS="-DGGML_CUDA=on"


export CUDA_PATH="/opt/cuda"

pip install --no-build-isolation --no-deps --force-reinstall .

cd .. && rm -rf llama-cpp-python
Сборка кастомного FlashAttention для Nvidia Tesla V100
Запускаем сборку расширения FlashAttention Tesla V100:
source ./venv/bin/activate
cd custom_nodes && git clone https://github.com/ai-bond/flash-attention-v100/ && cd flash-attention-v100
Редактируем requirements.txt
filelock>=3.25.2

fsspec>=2026.2.0

Jinja2>=3.1.6

MarkupSafe>=3.0.3

mpmath>=1.3.0

networkx>=3.6.1

ninja>=1.13.0

numpy>=2.4.4

packaging>=26.0

psutil>=7.2.2

setuptools>=82.0.1

sympy>=1.14.0

typing_extensions>=4.15.0

wheel>=0.46.3
pip install -r requirements.txt
Собираем расширение flash-attention-v100 с исправлением флага стандарта с c++17 на c++20 в setup.py :
source ./venv/bin/activate
cd $HOME/Data/comfui/custom_nodes/flash-attention-v100


rm -rf build dist *.egg-info


sed -i 's/-std=c++17/-std=c++20/g' setup.py


export TORCH_CUDA_ARCH_LIST="7.0"


export CC="/usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc"


export CXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"


export CUDAHOSTCXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"


export MAX_JOBS=4


pip wheel . --no-build-isolation --no-deps -w ~/backup_torch/ && cd .. && rm -rf flash-attention-v100


pip install ~/backup_torch/flash-attention-v100.whl —no-deps
Проверка:
python -c "import flash_attn; print(f'Успешно! Версия: {flash_attn.__doc__}')"

Как устанавливать ноды и запускать обновление кастомизированного ComfyUI?
Когда код ComfyUI обновляется через git pull, могут измениться версии вспомогательных библиотек. Чтобы обновить окружение, нужно активировать venv и запускать pip с флагом —no-deps (без автоматического разрешения зависимостей). Это заставит pip обновить только те пакеты, которые написаны в requirements:
source ./venv/bin/activate
pip install --no-deps -r requirements.txt
Чтобы не нарушать целостность самостоятельно собранных библиотек, новые ноды желательно устанавливать вручную. Для этого нужно перейти в папку custom_nodes и склонировать ее через Git, а затем проверить файл requirements.txt. Если его нет, значит, нода использует стандартный Python-код и сразу готова к работе.
Если там есть файл requirements.txt, его нужно установить безопасным способом с помощью утилиты grep, например:
source ../../venv/bin/activate
grep -vE 'torch|torchvision|torchaudio|xformers|bitsandbytes' requirements.txt > /tmp/req_safe.txt || true
pip install -r /tmp/req_safe.txt && rm -f /tmp/req_safe.txt
Для кастомных нод, которые компилируют собственные бинарные C++/CUDA-ядра, при сборке нужно указывать пути к системному GCC 14, например:
export CC="/usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc"
export CXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"
export CUDAHOSTCXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"
Чтобы при запуске ComfyUI кастомные ноды ничего не сломали в корне папки ComfyUI, нужно запускать этот бэкенд адаптированным скриптом run_comfy.sh:
#!/bin/sh

# 1. ПУТИ, ОКРУЖЕНИЕ И ПЕРЕМЕННЫЕ COMPILER (GENTOO + NATIVE)

# Фиксируем рабочую директорию проекта

cd $HOME/ComfyUI/

# Гарантируем видимость pip для ComfyUI Manager и фиксируем GCC 14

export PATH="/home/intel35/Data/ComfyUI/venv/bin:$PATH"

export CC="/usr/x86_64-pc-linux-gnu/gcc-bin/14/gcc"

export CXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"

export CUDAHOSTCXX="/usr/x86_64-pc-linux-gnu/gcc-bin/14/g++"

# Твики видеопамяти и CUDA ядра

export PYTORCH_CUDA_ALLOC_CONF="garbage_collection_threshold:0.6,max_split_size_mb:128,expandable_segments:True"

export CUDA_VISIBLE_DEVICES=0

export CUDA_MODULE_LOADING=LAZY

export COMFYUI_CRYSTOOLS_DEVICE="cuda"

export FLASHATTN_V100_AUTO_PATCH=1

# Отключение предупреждений и логов

export PYTHONWARNINGS="ignore"

export LOGURU_LEVEL="ERROR"

# Переопределение временной папки для pip

mkdir -p ~/pip_tmp

export TMPDIR=~/pip_tmp

# 2. УПРАВЛЕНИЕ ПИТАНИЕМ И РАЗГОНОМ TESLA V100

sudo nvidia-smi -pm 1

sudo nvidia-smi -i 0 -pl 190

sudo nvidia-smi -i 0 -ac 877,1530

# 3. АКТИВАЦИЯ ВИРТУАЛЬНОГО ОКРУЖЕНИЯ

if [ -f "./venv/bin/activate" ]; then

    source ./venv/bin/activate

else

    echo "Ошибка: виртуальное окружение ./venv не найдено!"

    exit 1

fi

# 4. ЗАПУСК COMFYUI С УКАЗАНИЕМ ИНТЕРПРЕТАТОРА И ПУТЕЙ VENV

export PYTHONPATH="$HOME/ComfyUI/venv/lib/python3.12/site-packages:$PYTHONPATH"

export PIP_EXECUTABLE="$HOME/ComfyUI/venv/bin/pip"

LD_PRELOAD="/usr/lib64/libjemalloc.so" PYTHONWARNINGS="ignore" /home/intel35/Data/ComfyUI/venv/bin/python3 main.py --preview-method auto --enable-manager --force-fp16 --fp16-unet --fp16-vae --fp16-text-enc --fp16-intermediates --fast --cuda-malloc --disable-metadata --fast-disk --enable-cors-header "*"
Делаем его исполняемым: chmod +x run_comfy.sh и после этого запускаем интерфейс ComfyUI только через него.

Вам также может понравиться
Вынос clip, vae и lora на другой компьютер в comfyui

О ресурсе и доработке cветодиодных источников света